Qwen3.8-27B er en open source-model, du kan køre på egen maskine, og den løste 66,8 procent af de 100 nyeste hårde opgaver på LiveCodeBench. Da forskeren Lee lod flere friske instanser af præcis samme model dele opgaverne op og koordinere gennem et fælles filsystem, steg tallet til 92,4 procent. Uden ny træning og uden en større model. Princippet er enkelt: flere små sprogmodeller deler én programmeringsopgave og taler kun sammen gennem filer på disken. Nu findes det som et færdigt workflow, team-solve i Memdoor, som du selv kan køre.
Det er multi-agent i sin mest nøgterne form: flere AI-agenter der samarbejder uden en fælles chat, uden en orkestrator med egen hukommelse og uden et menneske, der godkender undervejs. Antallet er ikke fast: paperet bruger friske instanser af én og samme model, mens team-solve fordeler arbejdet på fem roller. Kort fortalt virker det på opgaver, hvor en test kan afgøre, om svaret er rigtigt. Genkørslen fra holdet bag team-solve viser samtidig, hvor forsigtig du skal være med tallene, for det, tallene kan bære, er paritet med forskernes opsætning og ikke en forbedring.
Hvad Gorilla vs. 5 Humans fandt ud af
Paperet hedder "Gorilla vs. 5 Humans" og er skrevet af Lee hos Persis Capital Research Lab. Det lå øverst på Hacker News 25. oktober, og koden ligger under MIT-licens. Metoden kalder forfatteren ledger-based zero-shot self-orchestration. Et ledger er en hovedbog: et fælles sted, hvor alt, der er besluttet og gjort, står skrevet ned. Her består hovedbogen af en plan, en fil med noter og den aktuelle løsning, og hver ny instans af modellen læser den i stedet for at arve en samtale.
Metoden er testet på 11 åbne og lukkede modeller med gevinster på op til 25,6 procentpoint. Det mest omtalte resultat er Qwen3.8 Flash Next, som med orkestreringen nåede 93,0 procent pass@1 mod Fable 5's 90,4 procent, til 9 procent af prisen. Paperet er dog selv tydeligt på et vigtigt punkt: "Gains are not universal: some models are unchanged or worse." Nogle modeller får intet ud af det, og nogle bliver dårligere.
Hvorfor virker det så, når det virker? Forfatterens analyse af transskripterne peger på to ting: at problemet bliver delt op i mindre stykker, og at konteksten består på tværs af instanserne, fordi den ligger i filer og ikke i en chat.
Otte YAML-filer og ingen kode
Memdoor beskriver sig selv som "a lightweight coding and automation agent in one CLI binary". Værktøjet er Apache-2.0-licenseret, har omkring 164 stjerner på GitHub og kører lokalt eller over SSH, hvor det kan automatisere CI og cron-job med holdbare workflows. Team-solve er et af eksemplerne i repoet, og det består af otte YAML-filer. Der er ingen kode, og ingen model er navngivet.
Fem roller deler arbejdet: en planner, to idémagere, en solver og en manager. Når der skal rettes, kommer en repair-worker til. Forløbet ser sådan ud:
- plan læser task.md og skriver plan.md og notes.md.
- ideate-a og ideate-b kører parallelt. Den ene foreslår den mest direkte algoritme, der kan bevises korrekt, og den anden foreslår en fra en anden teknikfamilie.
- solve læser begge forslag og skriver solution.py og sin beslutning i notes.md.
- test er en kommando, der kører sample-testene, skriver test-output.log og aldrig får kørslen til at fejle.
- review er managerens trin. Den læser testoutputtet og skriver reparationsinstruktioner i notes.md, men ændrer ikke selv solution.py.
- repair laver højst én reparationsrunde.
- verify er igen en kommando, og en exit-kode forskellig fra 0 får hele kørslen til at fejle.
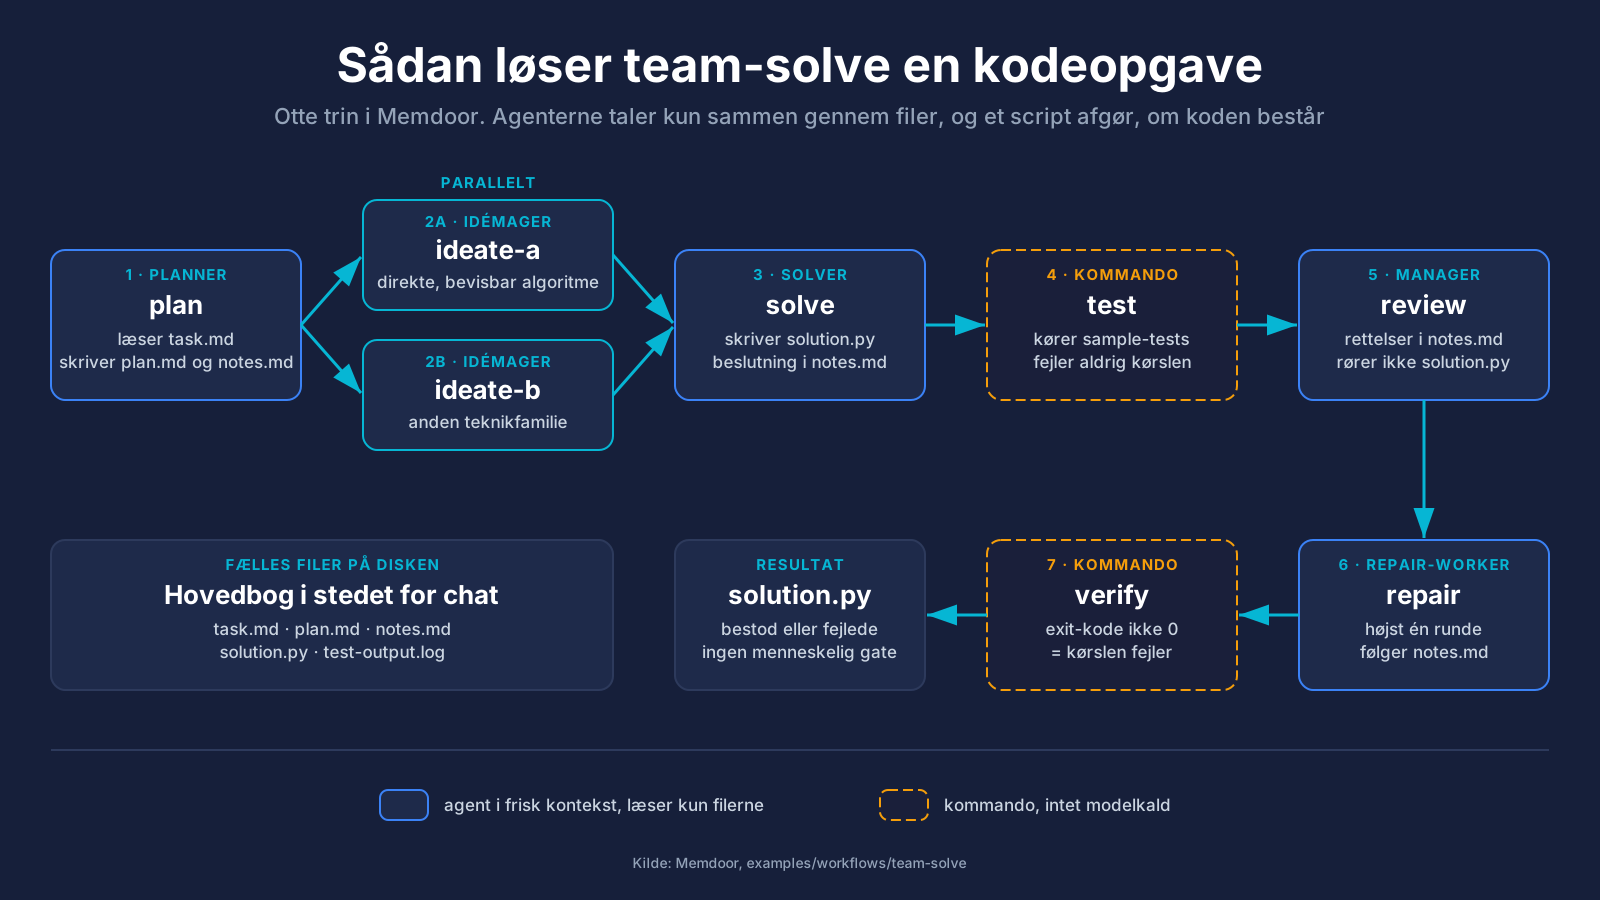
Der er ingen menneskelig gate nogen steder i forløbet. Til gengæld siger hver eneste agentprompt det samme: "fresh context, read the files, do not rely on chat". Det er den disciplin, team-solve-forfatterne tilskriver gevinsten, og den ligger tæt på paperets forklaring om vedvarende kontekst.
Hvorfor en frisk kontekst slår en lang chat
Lange samtaler med en sprogmodel driver. Tidlige beslutninger drukner i senere output, fejlede forsøg bliver hængende som støj, og modellen begynder at forholde sig til sin egen tidligere tekst frem for til opgaven. Det er samme mekanisme, der gør, at din kodeagent mister overblikket, selv når kontekstvinduet er stort nok på papiret.
Team-solve vender det om. Hver agent starter tomt og læser kun det, der står i filerne, og en fil indeholder kun det, nogen bevidst har valgt at skrive ned. Så bliver planen, beslutningen og reparationsinstruktionerne en kort, redigeret hukommelse i stedet for en lang, ufiltreret samtale. Det er en anden tilgang end at give én agent persistent hukommelse, for her er hukommelsen fælles og synlig for alle på holdet, også for dig, når du bagefter vil forstå, hvad der skete.
Den anden halvdel af designet er dommeren. Det er ikke en model, der beslutter, om løsningen er god, men et script, der kører testene. Princippet er kendt fra almindelig softwareudvikling: lad koden afgøre det, ikke en vurdering. En model kan overbevise sig selv om næsten hvad som helst, men en exit-kode kan ikke forhandles.
Paritet med paperet, ikke en sejr
For at tjekke workflowet genopbyggede team-solve-forfatterne paperets harness på samme model, Qwen3.8-27B, med paperets prompts, loop og et svarloft på 128K. De kørte de første 10 opgaver fra LiveCodeBench Hard fem gange og bedømte hver løsning på alle de skjulte tests.
| Gennemløb | team-solve | Paperets harness | Fable 5, ét kald |
|---|---|---|---|
| 1 | 10 | 9 | 7 |
| 2 | 10 | 10 | 8 |
| 3 | 10 | 10 | 10 |
| 4 | 10 | 9 | 8 |
| 5 | 9 | 10 | 7 |
| Gennemsnit | 9,8 | 9,6 | 8,0 |
En kørsel tog i median 40 minutter og kostede 0,39 dollar, og alle 50 kørsler kostede tilsammen 35,79 dollar. Forbeholdene vejer dog tungt, og forfatterne skriver dem selv:
- 10 opgaver er ikke paperets 100. Med så lille en stikprøve er 9,8 og 9,6 det samme tal.
- Opgaverne er fra foråret 2025 og kan have været med i modellens træningsdata, så kontaminering kan ikke udelukkes.
- Fable 5-kolonnen er paperets egne tal for ét kald pr. opgave og blev ikke kørt i denne harness.
- Modellen kørte via OpenRouter, ikke lokalt.
Det, tallene viser, er altså, at otte YAML-filer kan genskabe paperets resultat på en lille stikprøve. Det beviser ikke, at holdet slår en stor model.
Når holdet overskriver det rigtige svar
De mest lærerige detaljer ligger i fejlene. Den ene opgave, team-solve tabte, gik tabt, fordi manageren opfandt et modeksempel, der var forkert, og holdet derefter omskrev et program, der var korrekt. To andre gange blev et korrekt program overskrevet og først genvundet senere. Det var de to dyreste kørsler i forsøget, på 3,44 og 4,24 dollar mod en median på 0,39.
Mønstret er interessant, fordi det er den samme svaghed, holdet skulle beskytte imod: en model, der tror på sin egen påstand. Forfatterne foreslår to rettelser. Managerens modeksempel skal tjekkes mod en brute force-løsning på små input, før nogen handler på det, og workflowet skal beholde det seneste program, der bestod sample-testene, så en dårlig reparation ikke kan slette et godt svar.
Den første testkørsel ramte også et mere jordnært problem. En udbyder droppede streamen midt i et svar, og med max_retries: 0 døde hele kørslen. Nu har agenttrinene max_retries: 1, og en kørsel kan genoptages, så det arbejde, der allerede er færdigt, bliver bevaret. Den slags skiller et forskningsforsøg fra noget, der kan køre i en CI-pipeline om natten.
Små sprogmodeller passer til opgaver med et facit
Vil du bruge AI til kodning uden en stor cloudmodel, kører team-solve med enhver model, også lokalt via Ollama, llama.cpp, vLLM eller LM Studio. Bruger du Ollama, skal kontekstvinduet sættes til 32K. Det gør mønstret interessant for dig, hvis koden ikke må forlade huset, og det passer naturligt ind blandt andre lokale AI-kodeagenter.
Afvejningen er tid mod pris. Fem roller og to kommandoer betyder mange kald og en median på 40 minutter pr. opgave, hvor ét kald til en stor model tager et øjeblik. Til gengæld er hvert kald billigt, og kører modellen på egen hardware, er marginalprisen næsten væk. Til et svar, du skal bruge med det samme, er det for langsomt. Til en natlig kørsel, der skal løse en afgrænset opgave og bevise det, er det fint.
Den vigtigste betingelse er dog et facit. Mønstret giver mening, hvor et script kan afgøre resultatet: kode med tests, datatransformationer, hvor output kan sammenlignes med en forventning, og valideringer med klare regler. Uden en sådan dommer har du blot flere modeller, der er enige med hinanden, og så er der ingen grund til at tro på dem. Det samme gælder, når du bygger AI-agenter til faste arbejdsgange i virksomheden: tilliden skal ligge i det, der kan måles, ikke i hvor sikker modellen lyder.
Tommelfingerreglen er derfor enkel. Kan du skrive testen, før du beder om løsningen, kan flere små modeller med en fælles hovedbog nå langt. Kan du ikke, hjælper hverken holdet eller en større model dig med at vide, om svaret er rigtigt.
Kilder: Memdoor - team-solve · Lee 2026 - Gorilla vs. 5 Humans (arXiv 2608.26480)