Din agent har fået lov til at udføre en ændring i et eksternt system. Den sender kaldet afsted, og processen dør. Måske nåede ændringen at gå igennem. Måske kom kaldet aldrig frem. En ny agent starter op og finder en registrering, der siger "afsendt", men intet resultat.
Det scenarie er udgangspunktet for et indlæg af Manveer Chawla hos The New Stack, sponsoreret af databasefirmaet ClickHouse. Problemet er gammelt i distribuerede systemer. Enhver worker, der crasher midt i en ændring, efterlader den samme tvivl. Forskellen er, at en klassisk worker genoptager et fastlagt workflow fra sidste checkpoint, mens en AI-agent ræsonnerer selv. Det er selve kernen i hvad en AI-agent er: den vælger trinene undervejs i stedet for at følge en fastlagt kodevej. Får afløseren den samme opgave og ingen besked om, hvad der skete, kan den lægge en ny plan, vælge andre parametre eller beslutte at udføre handlingen forfra. Var den første allerede gået igennem, er den nu sket to gange.
Det er et af de centrale designproblemer for AI-agenter i produktion: hvordan udskifter du en agent midt i en operation uden at miste data eller kontekst, og uden at afløseren gentager noget, der allerede er sket? Chawlas svar er, at afløseren skal arve den oprindelige operation, ikke fortolke den på ny. Agenten er til at smide ud. Arbejdet er ikke.
Operationen skal overleve agenten
Alt det, der lever i agentens proces, er midlertidigt: variablerne i hukommelsen, konteksten og det løbende ræsonnement. Det er operationen ikke. Hvad der blev godkendt, med hvilke parametre og med hvilken status, skal kunne findes, selv om den agent, der startede arbejdet, aldrig kommer tilbage. En agent med persistent hukommelse løser ikke det problem, for hukommelsen dør eller lyver i præcis det øjeblik, det gælder.
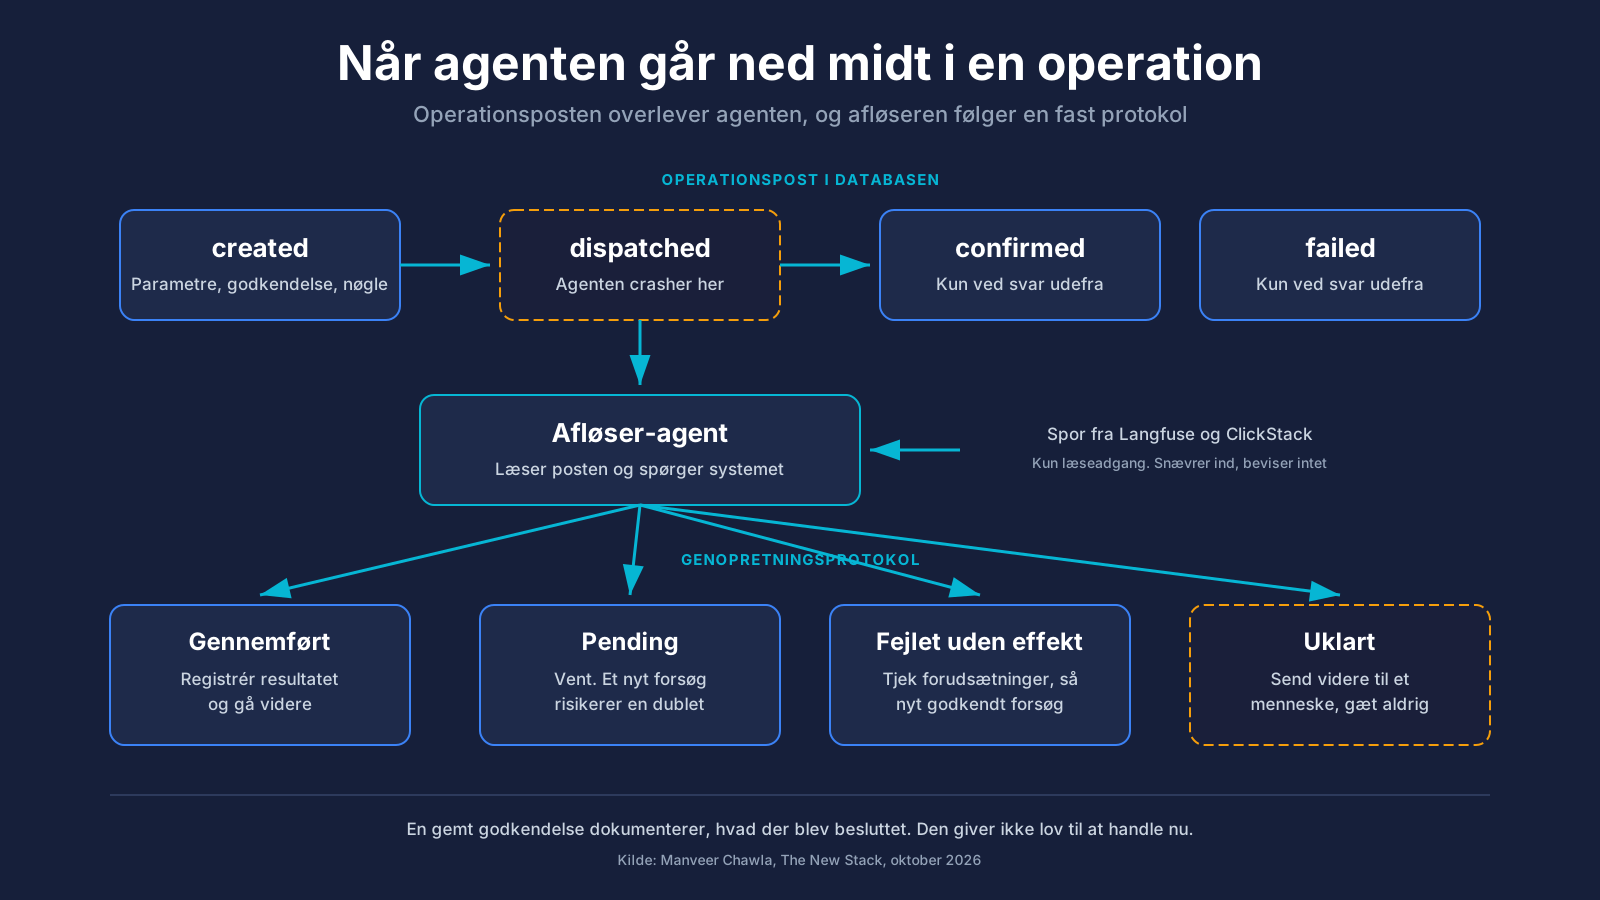
Løsningen i indlægget er en holdbar operationspost, som applikationen skriver i en transaktionel database, før handlingen sendes. Posten rummer de godkendte parametre, den godkendelse der gælder, en idempotensnøgle til det eksterne system, applikationens eget operations-id og en status, der følger et fast forløb:
| Status | Betyder |
|---|---|
| created | Operationen er godkendt og gemt, men intet er sendt |
| dispatched | Kaldet har forladt systemet, svaret er ikke registreret |
| confirmed | Det eksterne system har svaret, at ændringen er gennemført |
| failed | Det eksterne system har svaret, at ændringen ikke blev til noget |
Status skifter kun til confirmed eller failed på et svar fra det eksterne system, aldrig fordi agenten mener, det gik godt. En post, der hænger i dispatched, fortæller derfor afløseren præcis det, den skal vide: der blev gjort et forsøg, men resultatet blev aldrig skrevet ned. Med operations-id'et, som også er sendt med i det eksterne systems metadata, kan afløseren slå op, hvad der faktisk ligger derovre.
Værktøjsgrænsen bestemmer, ikke modellen
Posten er ikke kun kontekst til afløseren. Applikationen håndhæver den ved værktøjsgrænsen, altså laget, hvor agentens tool calls bliver til rigtige kald mod omverdenen. Hver udgående anmodning valideres mod den gemte post. Agenten kan foreslå næste skridt, men kun godkendte operationer med de oprindelige parametre og den oprindelige identitet slipper igennem.
Det flytter ansvaret et vigtigt sted hen. Modellen kan ikke definere om, hvad der blev godkendt, uanset hvor overbevisende dens ræsonnement er, eller hvor meget kontekst den har mistet. Det er samme princip, som når kodede agenter defineres med faste, typede værktøjer: modellen vælger, men koden bestemmer, hvad der overhovedet kan vælges. Promptinstrukser som "udfør aldrig handlingen to gange" er ønsker. Validering ved grænsen er en garanti.
Durable execution er ikke det samme som at genoptage arbejdet
Mange vil tænke, at det her allerede er løst af durable execution. Temporal og LangGraph gemmer, hvor langt et forløb er nået, og genoptager det efter et nedbrud. Men begge anbefaler selv, at trin med sideeffekter gøres idempotente, fordi en genstart ikke afgør, om sideeffekten nåede at ske. Blev ændringen gennemført, mens trinnet stadig stod som pending, kan rammen sagtens starte agenten igen. Den kan bare ikke fortælle afløseren, om det eksterne system modtog det oprindelige kald.
Her gør idempotensnøglen fra operationsposten arbejdet. Sender afløseren kaldet igen med samme nøgle, kan det eksterne system genkende det som samme operation frem for en ny. Det holder også, hvis det oprindelige kald først blev gennemført efter nedbruddet, eller hvis en worker, man troede var død, vågner op igen. Mønsteret er beskrevet i Amazons Builders' Library som et identifier fra kalderen, der gemmes atomisk sammen med ændringen.
Et nyt forsøg er alligevel ikke altid sikkert. Stripe dokumenterer for eksempel, at en 500-fejl på en ændring stadig kan have haft effekt, og at samme nøgle returnerer det første svar igen, også når det var en fejl. Når resultatet er ukendt, skal afløseren have beviser, ikke en kvalificeret gætning.
Spor snævrer ind, men beviser intet
I ClickHouses opsætning ligger forretningsdata og operationsposter i Postgres, som replikeres til ClickHouse med CDC. Applikationens telemetri går til ClickStack og agentens traces til Langfuse, begge med samme ClickHouse-instans som backend. Fordelen er, at én forespørgsel på operations-id'et kan binde operationen sammen med den agentkørsel, der sendte den, og det HTTP-kald, der fejlede. Ellers skal tre værktøjer stemmes af mod hinanden.
Det kræver to ting, som er lette at overse:
- Operations-id'et skal propageres manuelt hele vejen: i databaserækken, i trace-attributterne og i logkonteksten. Intet system korrelerer det for dig.
- Afløseren skal læse posten fra Postgres, ikke fra den replikerede kopi. CDC halter nogle sekunder bagefter, og den autoritative række er den, værktøjsgrænsen håndhæver.
Afløseren kan selv hente sporene via Langfuse' og ClickStacks MCP-servere, sådan som MCP som observability-lag for AI-agenter lægger op til. Men den skal kun have læseværktøjer. Sporene kan vise, at forgængeren sendte et kald med den gemte nøgle, og at forbindelsen derefter fejlede. De beviser ikke, at ændringen gik igennem. Et manglende trace beviser heller ikke, at kaldet aldrig blev sendt, for Langfuse sender traces asynkront, og et crash kan stoppe dem undervejs. Det eksterne system er og bliver kilden til sandheden om, hvad der skete derude.
Afløseren følger en protokol, ikke sin egen dømmekraft
Når afløseren har posten og eventuelle spor, skal den handle, men ikke ved at beslutte forfra, hvad opgaven kræver. Den følger den genopretningsprotokol, applikationen har defineret:
- Bekræfter det eksterne system, at ændringen er gennemført, registrerer afløseren resultatet og går videre.
- Står ændringen som pending eller i gang, venter afløseren. Et nyt forsøg risikerer en dublet.
- Er ændringen entydigt fejlet uden effekt, validerer afløseren forudsætningerne igen, før den laver et nyt godkendt forsøg.
- Er resultatet stadig uklart, eskalerer afløseren til et menneske i stedet for at gætte.
Selv når resultatet er afklaret, kan verden have flyttet sig. Tilstanden i det eksterne system kan være ændret. Et menneske kan have udført en lignende handling gennem en anden grænseflade, og nogen kan have trukket den oprindelige godkendelse tilbage. En gemt godkendelse er derfor dokumentation for, hvad der blev besluttet dengang, ikke tilladelse til at handle nu.
Chawla mener, at det egentlige spørgsmål for agenter i produktion ikke er, om de kan genstartes. Det er, om en helt ny agent kan finde ud af, hvad opgaven er lige nu, hvilke forpligtelser der stadig udestår, og hvilke effekter der måske er sket, og så fortsætte uden at tage forgængerens erindringer som autoritet. En agent, der ikke kan svare på det, er ikke klar til at blive udskiftet, og så er den heller ikke klar til produktion.
Kilde: The New Stack