
Efter tre timers fejlsøgning foreslår agenten en teori, den selv afviste for halvanden time siden. Den har ikke glemt det i den forstand, at teksten er væk. Den står stadig i samtalen. Men modellen læser den ikke længere som en konklusion, der udelukker noget. Enhver, der har kørt en lang debug-session med et AI-værktøj, kender mønsteret: kvaliteten falder, ikke fordi opgaven bliver sværere, men fordi sessionen bliver længere.
Sikkerhedsforskeren Jordy Zomer stødte på det samme under lange sårbarhedsanalyser og gjorde noget usædvanligt ved det. I stedet for at bygge endnu et hukommelsessystem oven på en vektordatabase behandlede han problemet som det, det er: vedligeholdelse af programtilstand.
Kontekstvinduet er ikke flaskehalsen
Den intuitive forklaring er, at modellen løber tør for plads. Den holder sjældent. Chromas undersøgelse af 18 frontier-modeller viste, at alle uden undtagelse bliver dårligere, efterhånden som inputtet vokser, og at forfaldet sætter ind længe før grænsen. En model med 200.000 tokens kontekst kan tabe markant præcision allerede ved 50.000.
Placeringen betyder mere end mængden. Nøjagtigheden er højest, når den relevante information står i begyndelsen eller slutningen af konteksten, og falder med over 30 procent, når den ligger i midten. Skal modellen finde flere sammenhængende oplysninger på én gang, falder træfsikkerheden fra omkring 95 til 60 procent. Og selvom alle de store udbydere i dag annoncerer en million tokens, ligger det brugbare vindue for de fleste modeller nærmere 200.000 til 400.000.
Det er derfor, persistent hukommelse til AI-agenter er blevet et selvstændigt felt. Men de fleste hukommelsessystemer gemmer observationer. De gemmer ikke observationernes konsekvenser. Når en grundantagelse vælter, står alle de konklusioner, der hvilede på den, stadig i hukommelsen som gyldige fakta. Som Zomer formulerer det: at fortælle en model, at noget er forkert, betyder ikke nødvendigvis, at den holder op med at tro på alt det, der byggede på det.
Da hukommelsen blev til programanalyse
Zomers system, Lemmalog, deler arbejdet i to. Modellen tager sig af det uskarpe: at læse kode, tolke debugger-output og oversætte naturligt sprog til påstande. En Datalog-motor tager sig af det deterministiske: at holde styr på fakta, anvende regler, spore afhængigheder og beregne konsekvenser.
Det afgørende er ikke, at fakta kan tilføjes. Det er, at de kan trækkes tilbage. Motoren registrerer, hvilke observationer hver konklusion hviler på, så en tilbagetrukket præmis automatisk invaliderer det, den bar. Samtidig kan en konklusion have flere uafhængige begrundelser og forblive gyldig, selvom den ene falder. Fakta kan knyttes til tidsintervaller, så systemet skelner mellem hvad der var sandt, og hvad der er sandt nu.
Forskellen til semantisk søgning er værd at holde fast i. En vektordatabase finder det, der ligner spørgsmålet. Den kan ikke udbrede konsekvensen af, at noget er blevet modbevist. Cosinus-lighed og sandhed er ikke det samme.
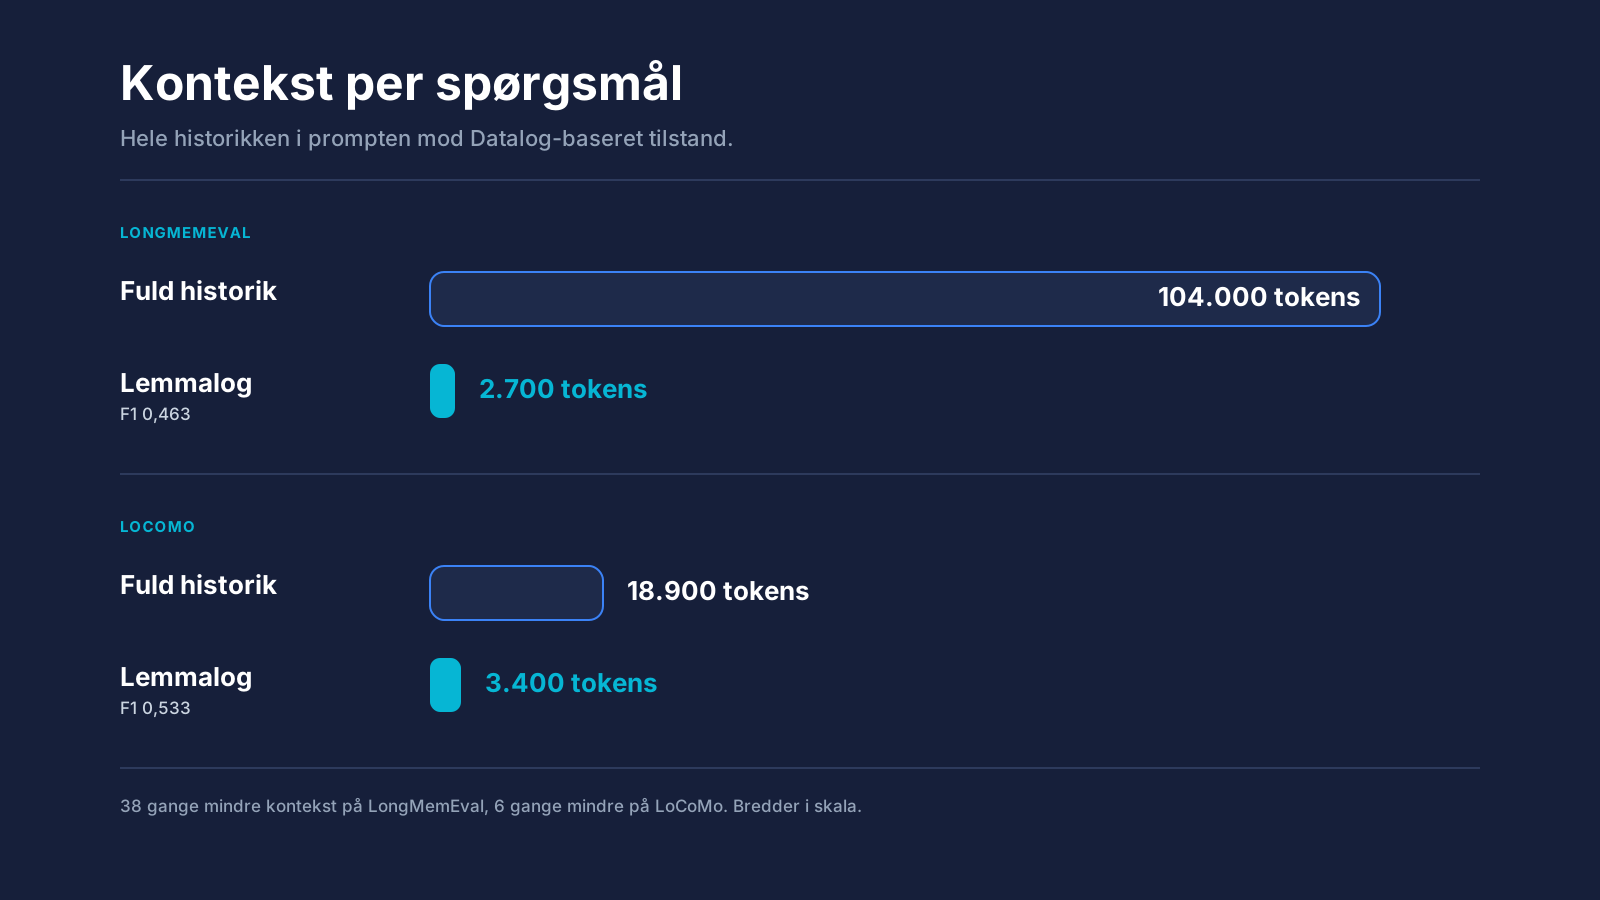
Resultaterne peger samme vej. På LongMemEval landede systemet 0,463 i F1 med omkring 2.700 tokens kontekst per spørgsmål, mod cirka 104.000 tokens for tilgangen, hvor hele historikken sendes med. Det er en faktor 38. På LoCoMo blev det 0,533 med omkring 3.400 tokens mod 18.900.
To kategorier skiller sig ud. På spørgsmål om opdateret viden, altså hvad man skal tro nu, når noget har ændret sig, nåede systemet 0,579 og slog det hidtil bedste offentliggjorte resultat. På modspørgsmål med falske præmisser ramte det 0,707 mod 0,509 for fuld kontekst, fordi det korrekt nægtede at svare på noget, der ikke var belæg for. Til gengæld er det svagt på ren slutning, 0,164, hvor et etableret system som PropMem ligger på 0,289 og samlet stadig fører.
Hvad Lemmalog er, konkret
Lemmalog er ikke et produkt. Det er et eksperimentelt open source-projekt under MIT-licens, skrevet i Rust og lagt frem på GitHub som JordyZomer/lemmalog. Der er ingen versionerede udgivelser, ingen pakke at installere, kun kildekoden og et designdokument med en ærlig statusliste over hvad der rent faktisk er bygget færdigt.
Repoet indeholder fire ting: selve Datalog-motoren som Rust-crate, en REPL til at arbejde med regler i hånden, en MCP-server der eksponerer motoren som værktøjer, og en agent-skill der beskriver arbejdsgangen.
MCP-serveren er den del, der er umiddelbart brugbar. Den bygges med cargo build --release --features mcp og registreres derefter i Claude Code eller Kimi CLI med en enkelt kommando. Serveren udstiller tolv værktøjer, og arbejdsdelingen er tydelig i navnene:
lemmalog_observetager de påstande, modellen har udtrukket fra samtalen, i et simpelt linjeformat med konfidenslemmalog_install_ruleslægger de regler ind, der udleder konsekvenser af påstandenelemmalog_querystiller spørgsmål til den udledte tilstand i stedet for at bede modellen ræsonnere forfralemmalog_whyreturnerer et bevistræ hele vejen tilbage til de oprindelige observationerlemmalog_what_ifafprøver en hypotese og ruller tilstanden tilbage bagefter, byte for byte
Tilstanden kan gemmes mellem sessioner ved at pege en miljøvariabel på en snapshot-fil ved registreringen. Skillen kopieres til ~/.claude/skills/ og gør motoren til arbejdshukommelse for enhver langvarig opgave, ikke kun sårbarhedsanalyse.
Forudsætningen er en Rust-værktøjskæde og vilje til at arbejde med et projekt, der har fungerende differentialtest, men ingen garanti for stabilitet mellem commits.
Fejlene lå i oversættelsen, ikke i motoren
Den mest anvendelige del af eksperimentet er ikke resultattavlen. Det er, hvor forbedringerne kom fra. Scoren gik fra 0,483 til 0,533, og stort set intet af det skyldtes ræsonnementsmotoren. Det skyldtes laget, der oversatte tekst til fakta.
- En simpel håndtering af flertalsformer genkendte ikke "owns" som samme begreb som "own", hvilket i stilhed ødelagde alle spørgsmål, der krævede optælling
- En datosammenligning sammenlignede interne symbol-id'er i stedet for faktiske datoer og kostede 20 F1-point på tidsrelaterede spørgsmål
- En utilsigtet formulering i instruktionen lærte systemet at afvise svar, det selv havde sammenstykket korrekt
Det er samme erfaring, som gælder for AI-kodning i store kodebaser: udbyttet afgøres sjældent af modellen. Det afgøres af, hvor disciplineret informationen omkring den er struktureret.
Hvorfor selvhostede modeller føles ubrugelige
Her bliver billedet mere nuanceret, end debatten om åbne vægte normalt tillader. På SWE-bench Verified ligger DeepSeek V4 Pro på 96,4 procent og Kimi K3 på 93,4 procent, altså foran flere lukkede modeller. Åbne vægte er ikke problemet.
Problemet er, hvad der rent faktisk kan køre på en maskine, man selv ejer. En 4-bit kvantiseret model kræver groft sagt sit parametertal i gigabyte, så en 32B-model fylder omkring 18 GB, før der overhovedet er afsat plads til kontekst. De modeller, der realistisk kan hostes på et enkelt kort, lander typisk mellem 60 og 72 procent, hvor de store frontier-modeller ligger på 80 til 95. Og fordi hukommelsen er delt mellem vægte og kontekst, betaler man dobbelt: den model, der lige akkurat passer i kortet, er også den, der først skærer kodebasen over midt i en refaktorering.
Oveni kommer det, som ikke er modellens skyld. Kvantisering koster præcision netop på den slags flertrinsræsonnement, fejlsøgning kræver. Et slankt harness uden ordentlig værktøjsbeskrivelse, filsøgning og kontekststyring giver dårligere resultater med præcis samme model. Når lokale AI-kodeagenter føles ubrugelige til seriøs kode, er det oftest en kombination: en for lille model, et for lille reelt kontekstvindue og en opsætning, der ikke gør noget for at holde styr på tilstanden. De to sidste kan man gøre noget ved.
Det er sessionens længde, der afgør udfaldet
METRs målinger sætter tal på, hvor grænsen går. Frontier-modeller løser tæt på 100 procent af de opgaver, en erfaren udvikler ville bruge under fire minutter på, og under 10 procent af dem, der tager mere end fire timer. Den opgavelængde, modellerne klarer med 50 procents pålidelighed, er fordoblet omtrent hver syvende måned i seks år. Retningen er tydelig, men den nuværende placering er lige så tydelig: jo længere en opgave løber, jo mere afhænger resultatet af noget andet end modellens rå evner.
Det er præcis det hul, Zomers eksperiment rammer. Vejen frem er ikke at få modellen til at huske bedre. Det er at holde analysens tilstand uden for modellen, så den ikke skal genopfinde sine egne konklusioner ved hver forespørgsel.
Hvad det betyder i praksis
For et udviklingsteam er den praktiske konsekvens ikke at skifte model. Det er at holde sessionerne korte og tilstanden eksplicit. Konklusioner, afviste hypoteser og bekræftede observationer hører hjemme i en fil, et issue eller et struktureret notat, som agenten læser fra, ikke i en samtale, der bare bliver ved med at vokse.
Det gælder dobbelt for opsætninger med egne modeller på egen hardware. Når det brugbare kontekstvindue er 32.000 tokens og ikke en million, er ekstern tilstandsstyring ikke en optimering. Det er forudsætningen for, at værktøjet kan bruges til andet end at skrive enkeltstående funktioner. Og modsat modelvalget er det noget, man selv kan bygge.
Kilde: pwning.systems
