
Strata kan kun køre én model, og sådan bliver det. Udvikleren bag har afvist både DeepSeek og GLM med samme begrundelse: kernerne og pakkeformatet er bygget omkring Qwen3.8-Flash-Next, og en anden arkitektur ville kræve ny loader, nye kerner og en ny draft-model. Fællesskabet har gjort arbejdet alligevel. Under to uger efter at Strata kørte Qwen 3.8 på en gaming-PC, findes der forks, der gør det samme med GLM-5.3-Flash på 320 milliarder parametre og DeepSeek V4 Flash på 284 milliarder.
De to største er Project Maya til GLM og Strata-DS4 til DeepSeek. Begge blev oprettet den 6. oktober. Ved siden af ligger fire åbne pull requests i selve Strata, der forsøger at få modellerne ind i hovedprojektet. Ingen af dem er merget.
Hvilke modeller tricket virker på
Strata virker kun på mixture-of-experts-modeller, hvor hvert ord kun bruger en lille del af vægtene. Det er hele idéen: de mest brugte eksperter ligger i grafikkortet, resten i RAM, og processoren regner på dem, kortet mangler. En tæt model som Qwen3.8-27B bruger alle sine vægte ved hvert ord, og så er der intet at fordele. Udvikleren lukkede en forespørgsel på netop den model med den forklaring, at llama.cpp er det rigtige værktøj til tætte modeller.
Det afgørende tal er derfor de aktive parametre, ikke modellens samlede størrelse. Jo flere vægte hvert ord skal bruge, jo mere data skal flyttes, og jo langsommere går det på en almindelig PC.
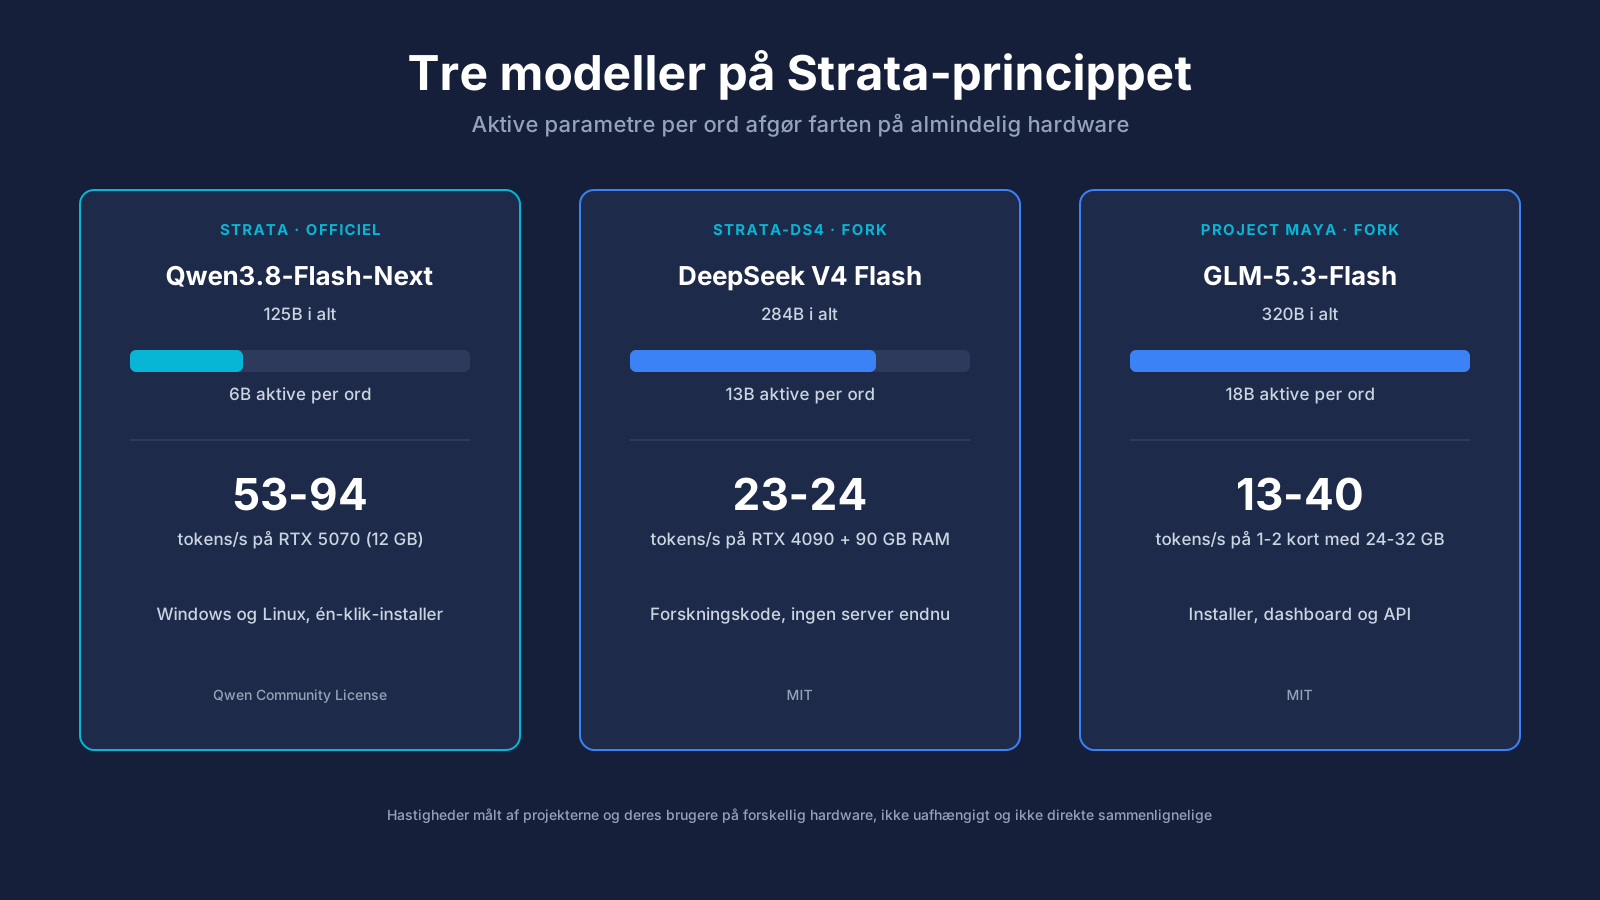
| Model | I alt / aktive | Licens | Strata-motor |
|---|---|---|---|
| Qwen3.8-Flash-Next | 125B / 6B | Qwen Community License | Strata (officiel) |
| DeepSeek V4 Flash | 284B / 13B | MIT | Strata-DS4 (fork) |
| GLM-5.3-Flash | 320B / 18B | MIT | Project Maya (fork) |
Qwen bruger 6 milliarder parametre per ord, GLM tre gange så mange. Det er forklaringen på, at Qwen-udgaven når 53 til 94 tokens i sekundet på et RTX 5070, mens de to andre ligger omkring 20 på kort med dobbelt så meget VRAM.
GLM 5.3 lokalt med Project Maya
Project Maya er den mest færdige af de nye forks. Motoren er Stratas, omskrevet til GLM-5.3-Flash, og den har sin egen installer, et dashboard i browseren og samme OpenAI- og Anthropic-kompatible API. Den kører på NVIDIA-kort fra V100 og RTX 20-serien og frem, med ét kort eller op til 16, og eksperimentelt på enkelte AMD-kort.
Kravene er højere end Stratas. Maya kører med 32 GB RAM, men vil have omkring 100 GB fri plads på en hurtig NVMe-disk, fordi de eksperter, der hverken er i VRAM eller RAM, læses fra disken undervejs. Linux er det primære system, Windows er eksperimentelt.
Projektet har lavet sine egne komprimerede udgaver af modellen ud fra Z.ai's FP8-udgave:
- Maya-S (96,5 GB): bevarer ifølge projektet 97,9 procent af FP8-modellens nøjagtighed på fem standardtest og vælger samme næste token som FP8-modellen 83 procent af tiden
- Maya-M (116 GB): samme nøjagtighed på de fem test, men tættere på originalen token for token, 86 procent
- GSQ-RCO 3,5-bit (137 GB): en fællesskabsudgave, der på MMLU-Pro måler 60,6 mod 62,0 for 8-bit
Hastighederne er beskedne sammenlignet med Qwen. Et enkelt V100 med 32 GB når op til 19 tokens i sekundet, to V100 op til 40. En bruger med to TITAN RTX måler 13,5, og et RTX 3090 med 120 GB RAM ligger omkring 20 med 3,5-bit-udgaven. Det er brugbart til en samtale, men ikke den fart, der gjorde Strata kendt.
DeepSeek V4 lokalt med Strata-DS4
Strata-DS4 er mere eksperiment end produkt. Det er én udviklers forskningskode, der overfører Stratas fordeling af eksperter til DeepSeek V4 Flash, en model som llama.cpp godt kan køre, men som ifølge udvikleren er usædvanligt svær at få hurtig på en almindelig PC. Den har 43 lag med 256 eksperter hver, og i 2-bit fylder eksperterne omkring 73 GiB.
Målt på et RTX 4090 med 24 GB, en Ryzen 7 5700X og 90 GB RAM skriver Strata-DS4 23 til 24 tokens i sekundet. Den bedste konfiguration af llama.cpp på samme maskine giver 16,3. Lange prompter læses med op til 392 tokens i sekundet. Udvikleren er selv klar i mælet: koden er målt på præcis én PC, har ingen server eller chat-brugerflade og kører én forespørgsel ad gangen.
En anden vej til samme model er DwarfStar fra Redis-skaberen Salvatore Sanfilippo, bedre kendt som antirez. Det er ikke en Strata-fork, men en selvstændig motor med samme filosofi: snævert bygget til få modeller i stedet for at køre alt. Den understøtter DeepSeek V4 Flash, GLM-5.3-Flash og Qwen3.8-Flash-Next og er primært lavet til Mac med 96 GB hukommelse eller mere. På en M5 Max når DeepSeek V4 Flash 39 tokens i sekundet, og et RTX PRO 6000 med 96 GB rammer 43.
Hvilken model er bedst?
Ifølge producenternes egne tal er GLM-5.3-Flash den stærkeste af de tre til agentarbejde. På DeepSWE 1.1 scorer den 63,4 mod Qwens 58,7, og på Toolathlon 78,4 mod 73,5. Qwen fører til gengæld på SWE-bench Pro med 62,5 mod DeepSeeks 56,0. GLM har ikke offentliggjort et tal der.
En uafhængig test på to NVIDIA DGX Spark kørte de tre modeller gennem de samme 40 opgaver fra SWE-bench Pro. Qwen og GLM løste begge 36, DeepSeek 33. Til gengæld skrev DeepSeek hurtigst med 41 tokens i sekundet mod Qwens 23 i FP8 og GLM's 21,5. Qwen læste lange prompter hurtigst og var klar med første token efter 51 sekunder ved 131.000 tokens kontekst, hvor DeepSeek skulle bruge 115.
Der er altså ingen klar vinder. GLM ser stærkest ud på agentopgaver, Qwen er hurtigst på forbrugerhardware, og DeepSeek skriver hurtigst, når hele modellen ligger i hukommelsen. Licensen trækker også i en bestemt retning: GLM og DeepSeek er under MIT, mens Qwen har sin egen fællesskabslicens.
Hvor modent er det?
Ikke særlig. Project Maya og Strata-DS4 er to dage gamle, når dette skrives. Maya har godt hundrede stjerner på GitHub, Strata-DS4 fire. Begge er målt på en håndfuld maskiner, og ingen af dem er testet på datacenterkort som H100 eller H200. Pull requests til GLM og DeepSeek i selve Strata ligger åbne, og udvikleren har sagt, at andre arkitekturer ikke er på planen.
Samtidig er Qwen4 på vej. Alibaba sagde på Apsara-konferencen den 22. september, at modellen er under træning og kommer "meget snart". Bygger den på samme arkitektur som Qwen3.8-Flash-Next, som Alibaba selv har kaldt en forsmag på Qwen4, kan Strata være klar fra første dag, mens GLM- og DeepSeek-forkene stadig er i gang.
Det mest interessante er derfor ikke den enkelte fork. Det er, at idéen bag Strata viste sig at kunne flyttes. At fordele eksperter mellem grafikkort, RAM og disk efter hvor ofte de bruges, virker på enhver sparsom model med få aktive parametre. Det, der skiller en hurtig lokal model fra en langsom, er ikke længere den samlede størrelse, men hvor mange vægte hvert ord skal bruge.
Kilder: Project Maya, Strata-DS4, NVIDIA Developer Forums
