
For en måned siden skulle man bruge omkring 96 GB hurtig hukommelse for at køre Qwen3.8-Flash-Next ordentligt. Nu kører den på en almindelig gaming-PC med et RTX 5070 på 12 GB og 64 GB RAM, med 53 til 94 tokens i sekundet. Det er hurtigere, end man kan nå at læse.
Det er open source-projektet Strata, der står bag. Repoet blev oprettet den 24. september, har på ti dage samlet over 10.000 stjerner og knap 900 forks på GitHub, og har udgivet 40 versioner. Den seneste, v0.1.39, kom i dag. Strata er en selvstændig inferensmotor skrevet i C++ under MIT-licens, bygget til at køre én model lokalt: Qwen 3.8 Flash i den store 125B-udgave.
Hvorfor en 125B-model kan køre på 12 GB
Tricket ligger i modellens opbygning. Arkitekturen i Qwen3.8-Flash-Next er en mixture-of-experts med 125 milliarder parametre i alt, men kun 6 milliarder aktive per token. Hvert af de 48 lag har 512 eksperter, altså 24.576 i alt, og hvert ord, modellen skriver, bruger kun 10 af dem plus én fælles.
Strata behandler det som et hukommelsesproblem i stedet for et regnekraftsproblem. Modellen behøver ikke ligge i grafikkortet. Den skal bare have de rigtige eksperter tæt på, når de skal bruges.
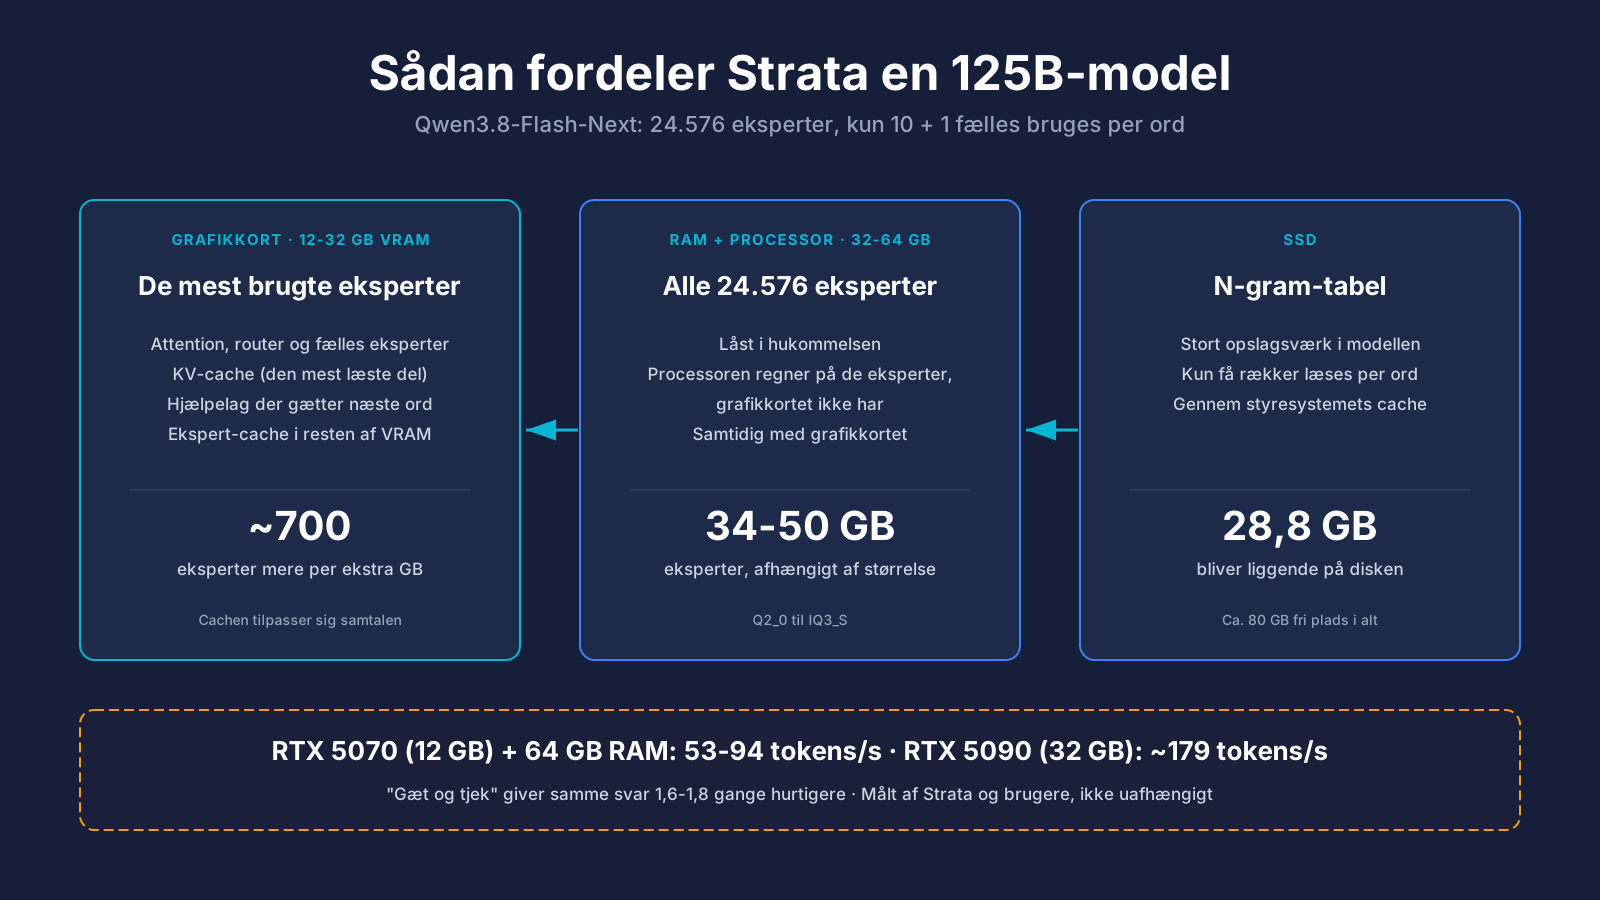
Fordelingen ser sådan ud:
- Grafikkortet holder de dele, der bruges ved hvert eneste ord, og fylder resten af hukommelsen med de eksperter, der bliver kaldt oftest. Hver ekstra GB VRAM giver plads til cirka 700 eksperter mere, og cachen tilpasser sig samtalen undervejs
- RAM holder alle 24.576 eksperter. Når et ord skal bruge en ekspert, kortet ikke har, regner processoren på den samtidig med grafikkortet, så ingen af dem venter
- SSD'en holder modellens n-gram-tabel på 28,8 GB, hvor der kun læses få rækker per ord
- Gæt og tjek. Et lille hjælpelag i modellen gætter de næste op til tre ord, og den store model tjekker dem i én omgang. Svaret bliver det samme, men kommer 1,6 til 1,8 gange hurtigere
Det virker, fordi de samme eksperter går igen. En bruger med RTX 5090 målte en ekspert-cache, hvor næsten alle kald blev ramt i grafikkortet. Så betaler man ikke for turen over PCIe-bussen ved hvert ord.
Hvor hurtigt Qwen 3.8 kører lokalt
Strata kommer i fire størrelser af den fulde model, komprimeret fra cirka 2 til 3,5 bit per vægt. Projektets egne målinger på en PC med RTX 5070 (12 GB), Ryzen 5 7600 og 64 GB RAM:
| Størrelse | Skriver svar | Læser prompt (32K) | RAM + VRAM |
|---|---|---|---|
| Q2_0 | 94 tokens/s | 2.650 tokens/s | 37,6 GB |
| IQ2_XS | 79 tokens/s | 2.090 tokens/s | 39,2 GB |
| IQ3_XXS | 62 tokens/s | 1.750 tokens/s | 47,0 GB |
| IQ3_S | 53 tokens/s | 1.620 tokens/s | 54,8 GB |
Mere VRAM betyder mere fart, fordi flere eksperter kan ligge i kortet. En bruger med RTX 5090 og 64 GB RAM har publiceret en reproducerbar måling med IQ2_XS: 179 tokens i sekundet ved en prompt på 4.096 tokens og stadig 165 ved 128.000 tokens. En japansk udvikler med to RTX PRO 4500-kort beskriver en hel arbejdsdag med kodning, 209 forespørgsler og en median på 96,5 tokens i sekundet, mod 30 til 60 med llama.cpp på samme maskine.
Til sammenligning rapporterede en udvikler kort efter modellens lancering 21 tokens i sekundet med en 4-bit-udgave på et RTX 4090 med standardværktøjer. Kvantiseringen var en anden, men det var samme model på et kraftigere kort, og under halvdelen af den fart, Strata får ud af et RTX 5070.
Hvad der kræves
Kravene er overraskende jordnære:
- Grafikkort: NVIDIA RTX 20-, 30-, 40- eller 50-serien eller et nyere AMD Radeon, med mindst 12 GB VRAM
- RAM: mindst 32 GB, og 64 GB for at kunne køre alle størrelser
- Disk: cirka 80 GB fri plads, helst SSD
- System: Windows 10, Windows 11 eller Linux
Med 32 GB RAM anbefaler Strata en særlig Coder-udgave, hvor halvdelen af eksperterne er fjernet. Ifølge dens udviklere når den 91 procent af den fulde models score på SWE-bench Verified, men den er svagere til alt andet end kode. Installationen er et script, der finder grafikkortet, vælger størrelse ud fra RAM og henter omkring 70 GB model. Første opstart kan få PC'en til at fryse i et til tre minutter, mens 35 til 55 GB lægges i hukommelsen.
Er den lokale model dårligere end Qwen 3.8 27B?
Det oplagte alternativ til lokal brug er den tætte Qwen3.8-27B, som er mindre og enklere at køre. Men i Qwens egen benchmarktabel, hvor de to står side om side, er den store Flash-model stærkest overalt. På DeepSWE 1.1 er det 58,7 mod 42,2, på JobBench 55,7 mod 33,4, og på Toolathlon 73,5 mod 67,1. Andre steder er forskellen lille: SWE-bench Pro giver 62,5 mod 61,7, og GPQA Diamond 91,7 mod 89,2.
Forbeholdet er, at de tal gælder den fulde model. Lokalt kører man en hårdt komprimeret udgave. Strata oplyser, at IQ3_S matcher den fulde model på deres publicerede test, mens 2-bit-udgaverne giver noget kvalitet væk for farten. Hvor meget, er ikke målt uafhængigt endnu. Kontekstvinduet er det samme som modellens: 262.144 tokens indbygget, men jo længere kontekst, jo mere hukommelse og ventetid koster det.
Til agenter og kodeværktøjer er det mest praktiske træk, at Strata taler både OpenAI's og Anthropics API-format på maskinen selv. Coding-agenter som Claude Code, Cursor og Codex kan pege på http://127.0.0.1:8080 i stedet for skyen uden ændringer i integrationen. Det er den del, der gør projektet til andet end en lokal chat-app.
Hvor Strata stopper
Strata er version 0.1, og det kan ses. Den åbne fejlliste rummer nedbrud på processorer uden AVX-512-instruktioner, fejl med Codex' nyere API-kald, problemer med værktøjskald og et ønske om bedre styring af hukommelsesbudgettet mellem RAM og VRAM. Der kommer nye versioner næsten dagligt, og det er både et godt og et dårligt tegn.
Den største begrænsning er arkitektonisk. Strata er bygget til at give én bruger høj hastighed. Som standard besvares én forespørgsel ad gangen, og resten venter. Man kan slå to samtidige til, men på et 12 GB-kort bliver hvert svar så langsommere. En server med datacenter-GPU'er, hvor hele modellen ligger i VRAM, er ikke nødvendigvis meget hurtigere for den enkelte bruger, men den kan betjene mange på én gang. Det kan en gaming-PC ikke.
Lange dokumenter er det andet sted, det mærkes. Første besked i en samtale læses fuldt ind med cirka et minut per 30.000 tokens. Opfølgende beskeder starter på sekunder, fordi samtalen gemmes, men en kodebase på 200.000 tokens tager flere minutter at komme i gang med.
Endelig er "intet forlader din PC" et løfte fra en README. Skal Strata bruges til følsomme data, bør installationsscripts, afhængigheder og netværkstrafik gennemgås, og modellens egen licens, Qwen Community License, læses. Den er ikke den samme som Stratas MIT-licens.
Det interessante ved Strata er derfor ikke overskriften om 125 milliarder parametre på en gaming-PC. Det er demonstrationen af, at en stor sparsom model kan køres som et spørgsmål om hvilke dele der ligger hvor, i stedet for at kræve det hele i grafikkortet. Til én udvikler eller et lille team med lokale kodeagenter er det allerede brugbart. Til en kundevendt tjeneste med mange samtidige brugere er det ikke værktøjet.
Kilde: Strata på GitHub
