
Alibaba udgav den 26. august Qwen3.8-Flash-Next med åbne vægte, og formuleringen i udgivelsesteksten er usædvanligt direkte: modellen er "en tidlig forsmag på den arkitektur, der bruges i Qwen4". Det er ikke en ny flagskibsmodel. Det er den næste generations motor, sat i en mindre kabine og sendt ud til offentligheden inden den rigtige bil er færdig.
Alibaba har gjort det før. Qwen3-Next spillede samme rolle for Qwen3.5 og introducerede den hybride Gated DeltaNet-arkitektur, som siden kørte videre gennem Qwen3.5, 3.6, 3.7 og 3.8. Den slags forudgivelse giver økosystemet tid til at bygge inferens-support, kvantiseringer og værktøjskæder, inden hovedmodellen lander.
Fire ændringer i arkitekturen
Modellen er en multimodal mixture-of-experts på 125 milliarder parametre med kun 6 milliarder aktive per token, plus en separat N-gram-tabel på 51 milliarder parametre. Kontekstvinduet er 262.144 tokens indbygget og kan strækkes til en million med YaRN. Ændringerne fordeler sig på fire områder:
- Qwen Sparse Attention. I stedet for at beregne relevans for hvert enkelt token grupperes tokens i mikroblokke, og en let indekserer udvælger kandidater på blokniveau. Attention bruger så sin regnekraft på de relevante områder
- Gated DeltaNet i tre ud af fire lag. Historikken komprimeres til en recurrent tilstand af fast størrelse. Det, der passer ind i den tilstand, koster ingen KV-cache overhovedet
- Gated Residual. Residualstrømmen udvides fra én bane til fire, med en dynamisk gate der styrer læsning og skrivning på hver
- N-gram Embedding og Muon. Embedding-tabellen slås op ud fra lokal kontekst og kan lægges i systemhukommelse med asynkron prefetch. Muon-optimeringen bruges til de todimensionelle vægte, mens AdamW beholdes til embeddings og router
Tilsammen er det ikke finpudsning. Det er en anden måde at fordele hukommelse og regnekraft på, og det er hele pointen med at sende den ud tidligt.
Springet fra forrige generation
Det interessante tal er ikke benchmarkscoren alene, men forholdet mellem score og forbrug. På SWE-bench Pro, der måler agent-kodning, lander Qwen3.8-Flash-Next på 62,5. Qwen3.7-Plus, en model der er tre gange så stor, ligger på 55. Alibaba oplyser samtidig, at træningen krævede omkring en niendedel af ressourcerne.
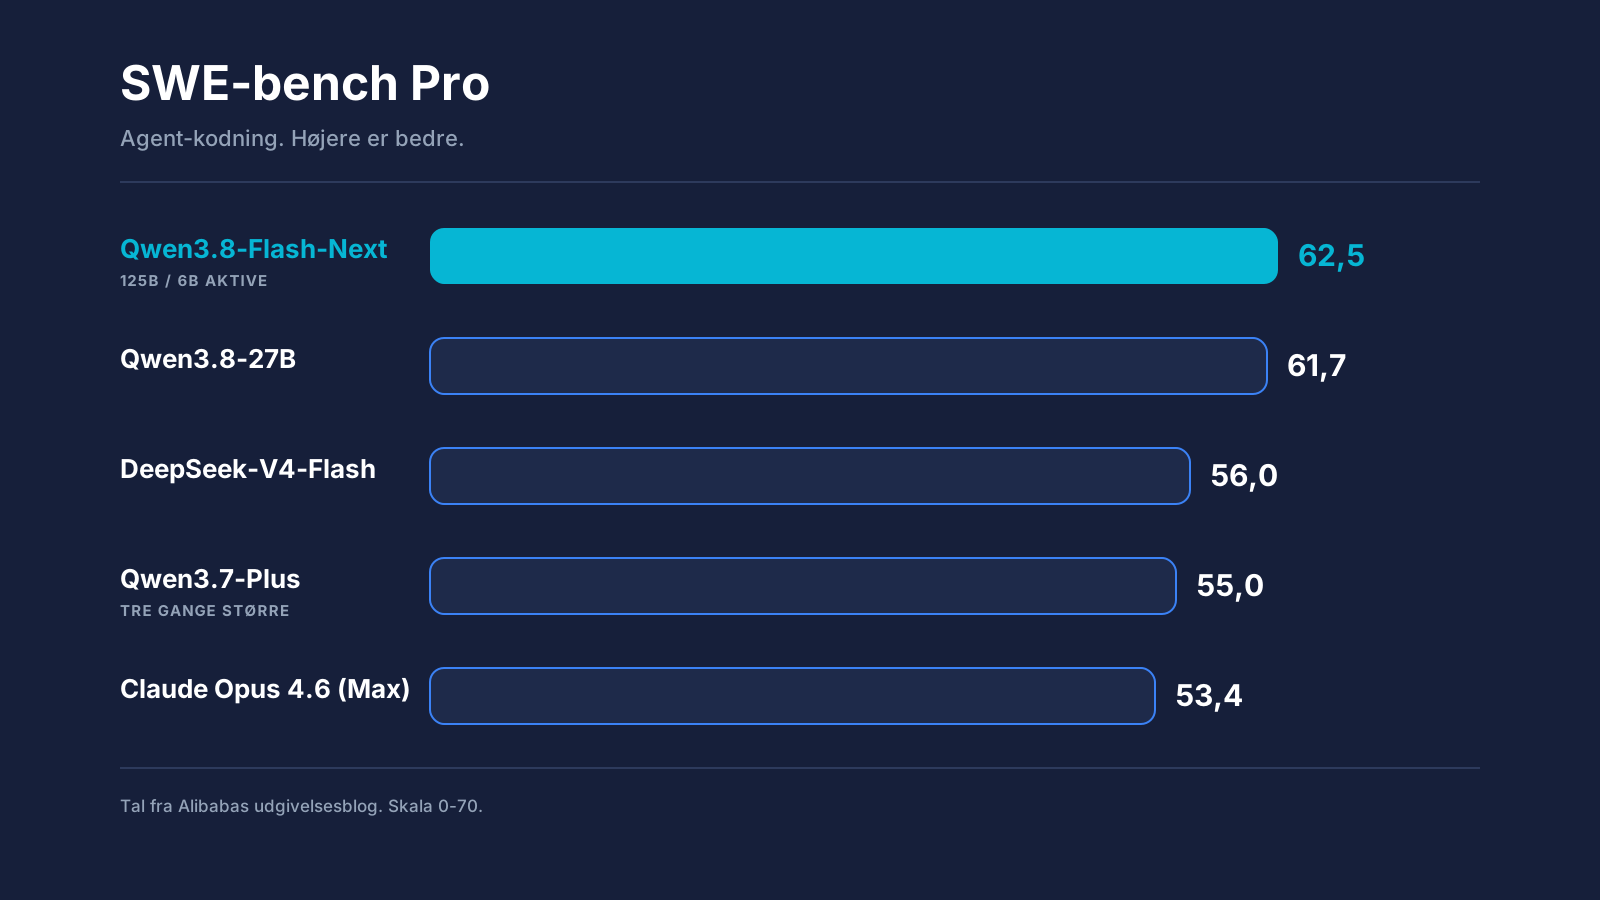
Den slår også Claude Opus 4.6 i kraftigste indstilling med 62,5 mod 53,4. På CoWorkBench, der måler langvarigt kontorarbejde, er forskellen 73,9 mod 68,2, og på JobBench 55,7 mod 36,6. Det er tal, der for et år siden ville have været utænkelige for en model, man kan hente og køre selv.
Sammenligningen med Alibabas eget flagskib sætter det i perspektiv. Da Qwen3.8-Max og DeepSeek V4 Pro landede samme uge i starten af august, var Max-modellen på 2,4 billioner parametre med 95 milliarder aktive per token. Flash-Next bruger 6 milliarder aktive og kommer inden for rækkevidde på flere agent-benchmarks.
Hvad den er god til
Profilen er tydeligt agent- og kodeorienteret. LiveCodeBench v6 lander på 91,9, Toolathlon Verified på 73,5, AndroidWorld på 84,5 og MathVision med kodefortolker på 95,7.
Prisen er den anden halvdel af argumentet. Via Alibabas API koster produktionsversionen omkring 1 krone per million input-tokens og cirka 3 kroner per million output-tokens. På QwenWork kører modellen desuden i en omskrevet standardtilstand, der ifølge Alibaba skærer token-forbruget per opgave med 75 procent og omtrent fordobler genereringshastigheden.
Hvad den fylder, og hvad den kræver
Den sparsomme aktivering er grunden til, at regnestykket overhovedet går op. Hver token rører kun en brøkdel af vægtene, så båndbreddebehovet ligger langt under hvad 125 milliarder parametre antyder. Det er derfor, det giver mening at køre modellen fra systemhukommelse, hvor en tæt model af samme størrelse ville være uspiselig langsom.
I fuld præcision fylder modellen 354 GB fordelt på tolv shards. Den udgave er til serverhardware. De kvantiserede GGUF-builds er dem, der er interessante på en arbejdsstation:
- 1-bit: 72,5 GB på disk
- 2-bit: 78,9 GB
- 4-bit: 93,7 GB for den mindste variant, 111 GB for den større
- 8-bit: 188 GB
Til at køre nogenlunde skal man have omkring 75 GB RAM eller unified memory. Det er den absolutte bund, og der er ikke plads til meget kontekst oveni. 96 GB er den realistiske minimumsgrænse, hvis modellen skal bruges til andet end demonstration.
Et kneb kan skubbe bunden længere ned. N-gram-tabellen på 51 milliarder parametre kan ligge på SSD og hentes asynkront, og så klarer den mindste build sig med 45,8 GB hurtig hukommelse. Til gengæld betaler man i latenstid.
Optimalt kører den to steder. En Mac med 128 GB unified memory, altså en M4 eller M5 Max, kører 4-bit-udgaven ved det fulde kontekstvindue på 262.144 tokens. Et GPU-setup med 96 GB VRAM kører 2-bit-udgaven helt i kortet.
Den mest interessante konfiguration er den billigste. Et enkelt 24 GB-kort med rigeligt systemhukommelse kan køre 4-bit med eksperterne liggende i RAM. En udvikler rapporterer 21 tokens i sekundet i generering og 364 i prefill på et RTX 4090 med 250.000 tokens kontekst, uden kvantiseret KV-cache.
Hvor den falder fra
Der er tre huller, og de er værd at kende, før man planlægger noget omkring modellen.
Computerbrug er det tydeligste. På OSWorld 2.0 løser den kun 19,4 procent af opgaverne fuldt ud. Den scorer 52,3 på delvis kredit, hvilket betyder, at den kommer i gang med de fleste opgaver, men sjældent afslutter dem korrekt. Til at styre en desktop autonomt er den ikke klar.
På ren viden og ræsonnement fører de lukkede modeller stadig. Humanity's Last Exam giver 35,9 mod Claude Opus 4.6's 40,0, og på NL2Repo-Bench ligger DeepSeek-V4-Flash foran med 54,2 mod 48,1.
Og så er der det, benchmarks ikke fanger. Modellen er ordrig i sin kraftigste ræsonnementsindstilling og har tendens til at vandre. Mac- og AMD-brugere kan endnu ikke udnytte den hukommelsesvenlige arkitektur fuldt ud. En udvikler på Hacker News formulerede skepsissen præcist: han ville gerne have at lokale modeller kunne erstatte de eksterne i dag, men det er ikke der endnu til professionel softwareudvikling. Det er samme skel, vi beskrev i gennemgangen af lokale AI-kodeagenter: afstanden mellem hvad benchmarks viser, og hvad der holder i en lang arbejdssession.
Hvad det betyder for Qwen4
Alibaba har ikke meldt en dato ud, men markedsforventningen peger på september. Når arkitekturen allerede ligger offentligt tilgængelig, er det ikke længere et spørgsmål om hvad Qwen4 kommer til at bygge på. Det er offentliggjort, testet af tredjeparter og understøttet i inferens-værktøjer, inden modellen overhovedet er annonceret.
For virksomheder, der overvejer selvhostede modeller, ændrer det regnestykket på et konkret punkt. Barrieren har hidtil været, at åbne modeller på frontier-niveau kræver serverhardware, ingen har stående. Med 6 milliarder aktive parametre og eksperter, der kan ligge i systemhukommelse, flytter grænsen sig ned til en velbestykket arbejdsstation. Om kvaliteten så holder i en lang session er stadig et andet spørgsmål, og det svar skal måles på egne opgaver, ikke på en benchmarktavle.
Kilde: The New Stack
