
En sprogmodel deler sig op i et hold, løser en opgave, bedømmer resultatet og bliver bagefter trænet på sit eget bedste arbejde. Det er idéen bag MASS, som det japanske AI-firma Sakana AI offentliggjorde den 8. oktober sammen med forskere fra UC Berkeley, blandt dem Databricks-medstifter Matei Zaharia. Der er ingen menneskelig dommer og ingen stærkere model i løkken. Efter to runder løste modellen forskningsopgaver bedre end før og fik mere ud af hvert token.
AI der forbedrer sig selv uden et facit
Det er ikke nyt, at AI kan forbedre sig selv på opgaver med et facit. Kode kan testes, og et regnestykke er enten rigtigt eller forkert. Sakana viste det selv sidste år med Darwin Gödel Machine, en kodeagent der omskrev sin egen kode og gik fra 20 til 50 procent på SWE-bench, fordi hver ny version kunne testes automatisk.
Det svære er opgaver uden facit, som en analyse, en forskningsrapport eller et strategiforslag. Her er der ingen test, der afgør, hvad der er rigtigt, og selv eksperter er ofte uenige. Det er den slags opgaver, MASS er bygget til. Navnet står for Multi-Agent Self-Supervision: modellen holder øje med sig selv ved at arbejde som et hold.
Sådan træner modellen sig selv
Forsøget brugte Alibabas åbne model Qwen3.6-27B i kodeagenten Qwen Code. Den samme model har tre roller på én gang. Den løser opgaven, den bedømmer resultatet, og den skriver arbejdsgangen om.
Arbejdsgangen er en almindelig tekst, der beskriver holdet: hvilke roller der er, hvad hver rolle skal gøre, hvilke resultater der skal afleveres, og i hvilken rækkefølge agenterne kalder hinanden. En styrende agent fordeler arbejdet til underagenter. Den opbygning kender mange fra AI-automatisering i virksomheder. Forskellen er, at modellen her selv skriver opskriften om.
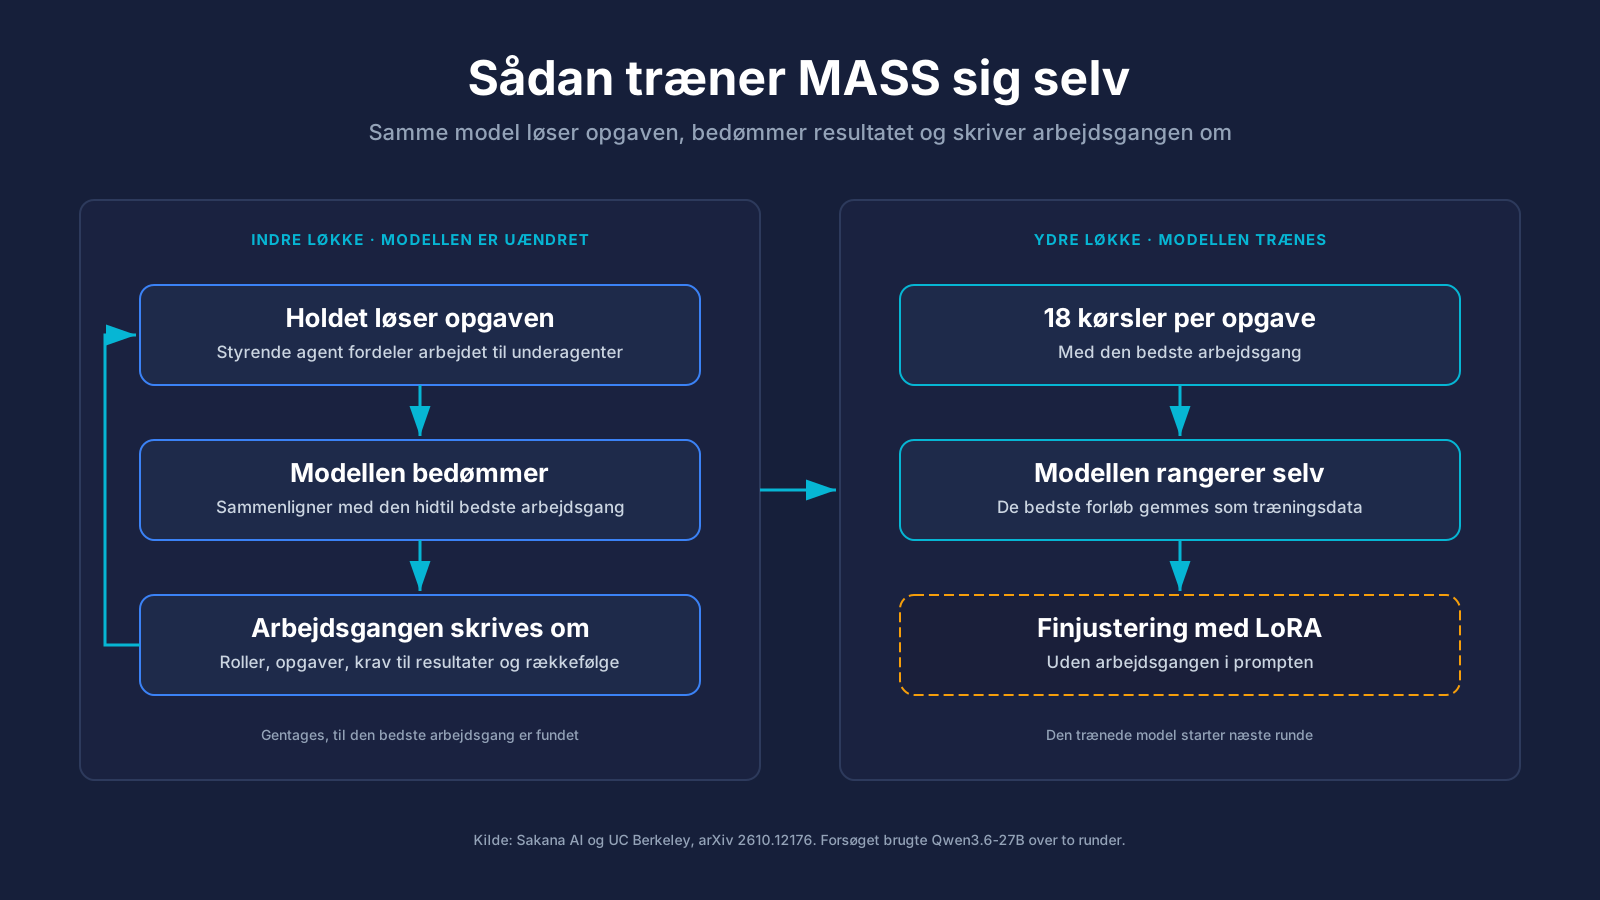
Processen kører i to løkker. I den indre løkke er modellen uændret. Holdet prøver en ny udgave af arbejdsgangen, modellen sammenligner resultatet med den hidtil bedste, og arbejdsgangen bliver skrevet om ud fra sammenligningen. I den ydre løkke køres den bedste arbejdsgang 18 gange per opgave, modellen rangerer selv resultaterne, og de bedste forløb bruges til at finjustere modellen. Arbejdsgangen fjernes fra prompten inden træningen, så modellen lærer at arbejde på den måde uden at få det at vide.
Det sidste trin er pointen. Holdets måde at arbejde på ender i selve modellen, og næste runde starter fra en model, der allerede er bedre.
Hvor meget bedre blev den?
Sakana testede på 12 forskningsopgaver inden for finans, robotteknologi og farmaci. Tre af dem blev holdt helt uden for træningen. For at måle fremskridtet brugte forskerne GPT-5.5 og Claude Opus 4.8 som eksterne dommere, men MASS fik aldrig deres vurderinger at se.
- På de tre testopgaver vandt modellen over udgangspunktet i 53,9 procent af sammenligningerne efter første runde og i 69,9 procent efter anden.
- På fire offentlige benchmarks for forskning og dataanalyse, blandt andet MLR-Bench og DSBench, scorede den 1,2 til 1,6 gange så højt per genereret token.
- Modellens egne vurderinger kom tættere på de eksterne dommeres. Enigheden steg fra 73 til 93 procent.
- Til kodning blev den ikke bedre. På SWE-bench Verified og Terminal-Bench 2.0 landede den en anelse under udgangspunktet.
Holdarbejdet gav også bedre træningsdata. En model trænet på holdets forløb slog en model trænet på en enkelt agents forløb, selv om den sidste fik næsten halvanden gang så mange tokens. De eksterne dommere foretrak holdets svar frem for en enkelt agents i 85 procent af tilfældene, men holdet er ikke gratis i drift. Det brugte 2,4 gange så mange tokens.
Den svage plet er den, der skriver om
Når en model bedømmer sig selv, er der en indbygget risiko. Har den en blind vinkel, belønner den sine egne fejl, og fejlen vokser for hver runde. Forfatterne nævner det selv som et sikkerhedsproblem.
Overraskende nok viste dommeren sig ikke at være det største problem. Da forskerne kun skiftede dommeren ud med GPT-5.5, hjalp det lidt. Da de også lod GPT-5.5 skrive arbejdsgangen om, fandt systemet en vindende arbejdsgang til alle 12 opgaver inden for fem forsøg. Med Qwen i alle roller tog det 13 forsøg at nå 11 af de 12. Flaskehalsen er altså evnen til at forbedre arbejdsgangen, ikke evnen til at bedømme den.
Forsøget er også lille. Der er kun 12 opgaver, to runder og én model, og søgningen efter arbejdsgange er ustabil, så et godt forsøg kan blive fulgt af et langt dårligere. Koden ligger åbent på GitHub, men de trænede vægte følger ikke med.
MASS er ikke den løbske AI der forbedrer AI, som debatten om rekursiv selvforbedring kredser om. Det interessante er noget mere jordnært: den måde, et hold af agenter arbejder sammen på, kan læres og bygges ind i én model.
