
En praktiserende læge vil spørge sin AI-assistent, hvilke patienter der mangler opfølgning på blodprøver. En advokat vil have et overblik over, hvilke sager der har frist i næste uge. Begge dele kræver, at en agent slår op i et system fuld af PII, altså personhenførbare oplysninger: CPR-numre, diagnoser, adresser og klientforhold. Det klassiske svar er at maskere persondata, før de sendes til ChatGPT, Claude eller Gemini. Det svar er ikke længere nok.
Matt DeBergalis, direktør og medstifter af Apollo GraphQL, skriver i dag i The New Stack, at det at forbinde en agent med et internt API er blevet den nemme del. Den svære del er at bestemme, hvad agenten må se, når den først er kommet ind. Hans pointe gælder langt ud over ordresystemer. Den rammer alle brancher, hvor tavshedspligt ikke er en anbefaling, men lov.
MCP åbner døren, men vælger ikke hvad der kommer ud
Model Context Protocol, MCP, er den standard, de fleste agenter i dag bruger til at finde og kalde værktøjer. Et MCP-værktøj til et journalsystem kan på en eftermiddag gøre patientdata tilgængelige for en sprogmodel. Det er netop det, der gør MCP populært, og det er også problemet.
MCP-specifikationen har OAuth, så man kan styre, hvem der må tale med serveren. Den siger derimod intet om, hvilke felter i et svar agenten må se. Returnerer journal-API'et hele posten, ryger hele posten ind i modellens kontekstvindue og videre til modelleverandøren. At systemprompten beder modellen ignorere CPR-nummeret, ændrer ikke på, at nummeret allerede er sendt.
Det står også i OWASP's liste over de ti største risici i sprogmodel-applikationer. I 2025-udgaven rykkede lækage af følsomme oplysninger fra sjettepladsen til andenpladsen, og risikoen for, at en agent får for mange rettigheder, blev udvidet med tre underpunkter: for mange værktøjer, for brede rettigheder og for meget selvstændighed. OWASP's råd er det samme hele vejen igennem: håndhæv sikkerheden uden for modellen og deterministisk, ikke i prompten. Det er også grunden til, at AI-automatisering i regulerede brancher står og falder med adgangsstyringen og ikke med modelvalget.
Anonymisering af persondata løser kun halvdelen
Klassiske PII-værktøjer som Microsofts open source-projekt Presidio, der i år er flyttet til et fællesskabsdrevet projekt, finder mønstre i tekst. De ser noget, der ligner et CPR-nummer, en e-mail eller et navn, og erstatter det med en maske eller en nøgle, der kan vendes tilbage bagefter. Det er nyttigt, og det bør være en del af enhver pipeline. Men det besvarer ét spørgsmål: hvad slags data er det her?
Det spørgsmål rækker ikke til en agent. En diagnose er ikke formateret som et CPR-nummer. En note i en advokatsag om, at klienten overvejer at sælge sit firma, ligner almindelig tekst. Interne priser, fraud-scores og forhandlingsstrategier er slet ikke persondata, men de må stadig ikke forlade huset.
Hertil kommer, at pseudonymisering er svagere, end mange tror. I februar 2026 viste forskere fra blandt andet ETH Zürich, at en sprogmodel med internetadgang kunne genkende anonyme brugere ud fra det, de skrev, med op til 68 procent træfsikkerhed ved 90 procents præcision. Det Europæiske Databeskyttelsesråd, EDPB, slog allerede i sine retningslinjer fra januar 2025 fast, at pseudonymiserede data stadig er persondata, hvis de kan kobles tilbage til en person. At skrive PATIENT_017 i stedet for et navn flytter ikke behandlingen uden for GDPR.
| PII-maskering | Politik på feltniveau | |
|---|---|---|
| Spørgsmålet | Ligner det her en personoplysning? | Må netop denne agent se netop dette felt? |
| Metode | Mønstergenkendelse i tekst | Regler knyttet til datamodellen |
| Fanger | CPR, e-mail, telefon, navne | Alt, der er klassificeret, også priser og noter |
| Fejltype | Sandsynlig: overser eller overmaskerer | Deterministisk: feltet kommer med eller ej |
| Handlinger | Ingen styring | Styrer også, hvad agenten må ændre |
Agenten ser kun de felter, den har ret til
DeBergalis' løsning er at lægge et lag mellem de interne systemer og MCP-serveren, som definerer præcis hvilke felter og handlinger hver agent har adgang til. Han foreslår GraphQL, fordi det sprog allerede er bygget op om, at den, der spørger, skal navngive de felter, den vil have. Spørger agenten efter en patients næste aftale, får den dato og klokkeslæt. Resten af journalen findes ikke i svaret.
Reglen sidder på feltet og ikke på værktøjet. I Apollos implementering markerer man i skemaet, at et felt kræver et bestemt scope eller en politik, og så gælder det, uanset hvilket værktøj eller hvilken agent der spørger. Man skal ikke huske at fjerne CPR-nummeret i hvert af de tyve værktøjer, fire teams har bygget. Man fjerner det én gang, og så er det væk overalt.
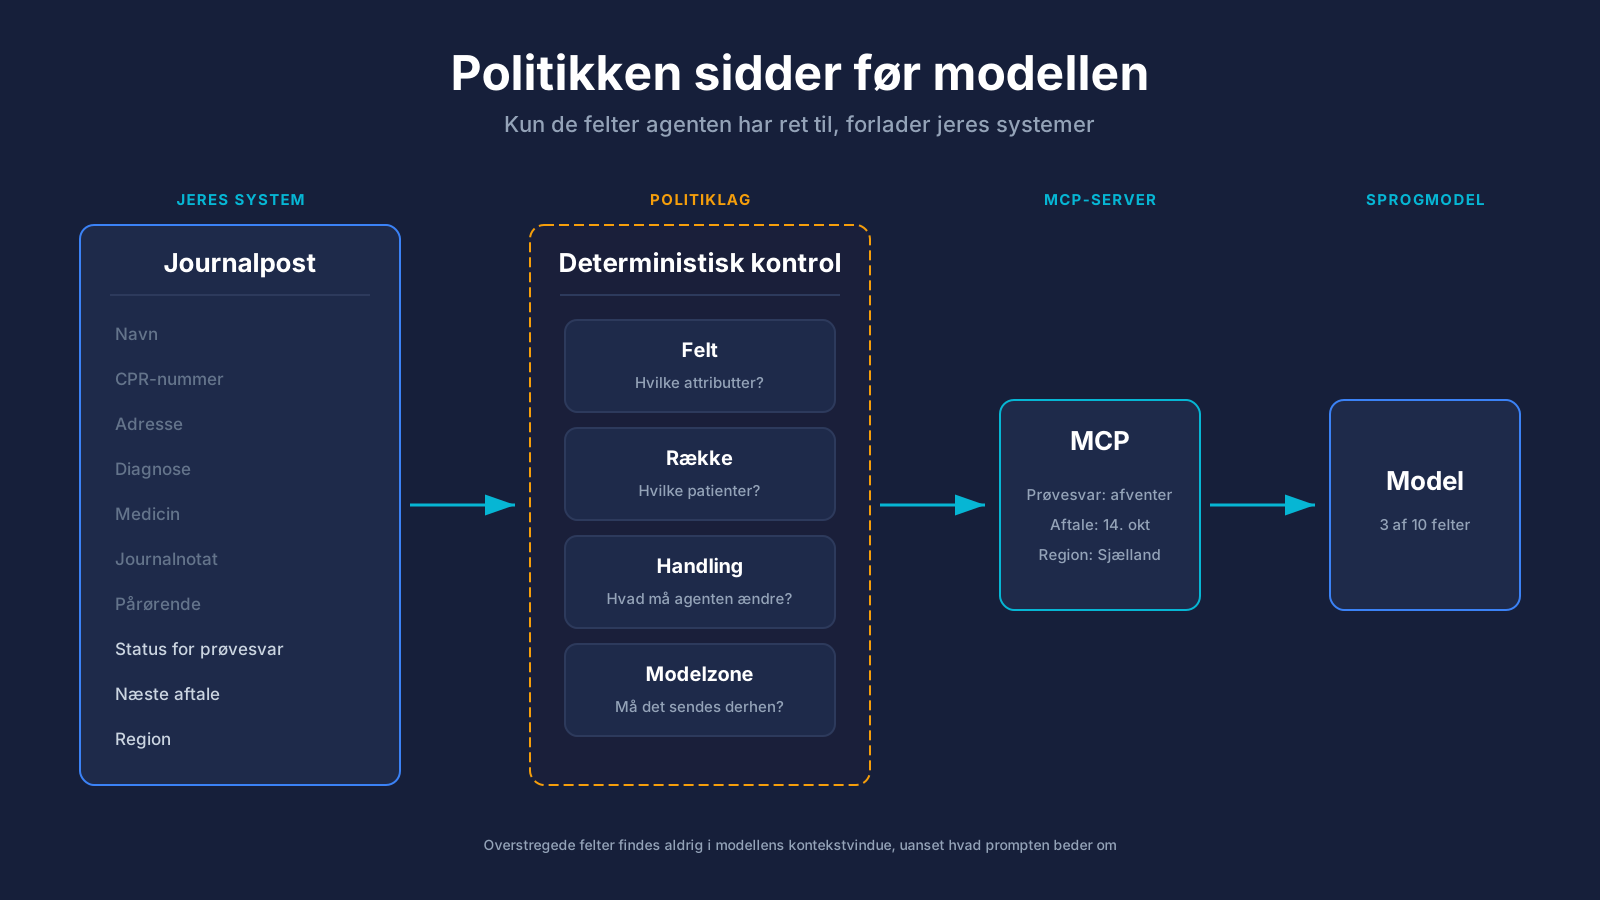
Det samme gælder skrivninger. Der er stor forskel på at give en agent et generelt værktøj, der kan kalde et vilkårligt endpoint i journalsystemet, og at give den én navngiven handling som opretAftaleForslag. Den første er i praksis fuld programmerbar adgang. Den anden er én forretningshandling, som systemet selv validerer. Det beskytter også mod prompt injection. Står der i en indkommende mail, at agenten skal sende alle patienter med en bestemt diagnose til en ekstern adresse, sker der ingenting, hvis feltet ikke findes i agentens kontrakt, og der ikke er noget værktøj, der kan sende noget ud.
Laget behøver ikke være GraphQL, og man behøver ikke skrive de underliggende systemer om. Det kan sidde oven på REST, SOAP eller en gammel database. Det vigtige er, at der findes ét sted, hvor politikken håndhæves, og at det sted ligger før data når modellen.
Når det skjulte felt er det vigtige
Den åbenlyse indvending er, at en agent uden de rigtige oplysninger giver forkerte svar. Skal den vurdere, om en hjemmesygeplejerske når ud til en borger i dag, er adressen måske netop det, der afgør sagen. Skjuler man den, gætter modellen.
Løsningen er sjældent enten at sende alt eller at sende intet. Der er typisk tre veje:
- Send feltet, hvis det er nødvendigt for opgaven, og risikoen er vurderet og accepteret.
- Send en grovere udgave. I stedet for en adresse i Kalundborg får modellen "Region Sjælland" eller "rutezone 3".
- Regn det ud internt. Jeres eget system beregner køretiden og sender kun "forventet ankomst 14.30, risiko for forsinkelse høj".
Den sidste er ofte den stærkeste. Modellen skal ikke vide, hvor borgeren bor, for at skrive en besked til vagtplanlæggeren. Den skal vide, at der er et problem. Princippet er ikke mindst mulig data. Det er mindst mulig data, der stadig giver det rigtige svar, og det er en afvejning, der skal laves opgave for opgave.
Man kan også lade modelvalget indgå i politikken. Klassificér hvert felt som offentligt, internt, fortroligt eller følsomt. Interne felter må gå til en ekstern model med databehandleraftale og nul datalagring. Fortrolige felter kun til en model i en europæisk enterprise-tenant. Følsomme felter, som diagnoser og CPR, kun til en model, der kører lokalt eller i fortrolig AI i en hardware-enklave. Så bliver det ikke et spørgsmål om at vælge én model til hele organisationen, men om at sende hver forespørgsel derhen, hvor dataene må være.
Lægen og advokaten har tavshedspligt, ikke modellen
I sundhedssektoren er presset konkret. Talegenkendelse og AI-assisteret journalføring er rullet ud på hospitalerne, og Datatilsynet har AI i sundhedssektoren blandt sine fokusområder for tilsyn i 2026. Samtidig viser et studie fra Københavns Universitet fra marts, at læger på et dansk hospital i gennemsnit blev afbrudt 40 gange per vagt for at rette fejl i talegenkendelsen. Hver rettelse er i praksis træningsdata, der sendes tilbage til leverandøren. Også her er spørgsmålet, hvad der forlader huset, og hvem der har besluttet det.
For advokater har en amerikansk dom gjort risikoen håndgribelig. I februar afgjorde dommer Jed Rakoff i New York, at en tiltalt direktørs samtaler med forbrugerversionen af Claude om sit eget forsvar ikke var beskyttet af advokatens tavshedspligt. Begrundelsen var, at samtalerne ikke var fortrolige, og at Claude hverken er advokat eller underlagt disciplinære regler. Dommen handler om en klient, der selv brugte et gratis værktøj, og ikke om et advokatkontor med en enterprise-aftale. Men den viser, at domstolene ser på, om der blev taget rimelige skridt for at bevare fortroligheden. Legal tech-leverandører som Harvey og Legora sælger sig netop på nul datalagring hos modelleverandøren og ingen træning på kundedata. Det er en kontrakt. En politik på feltniveau er det tekniske værn, der sikrer, at kontrakten aldrig bliver sat på prøve.
Det der stadig slipper ud
Et politiklag styrer, hvad værktøjerne returnerer. Det styrer ikke alt, hvad der ender hos modelleverandøren.
- Brugerens egen prompt. Skriver lægen patientens navn og diagnose i spørgsmålet, er de sendt, før noget lag får en chance.
- Værktøjsbeskrivelser. Navne og beskrivelser på MCP-værktøjer indgår i modellens kontekst. Et værktøj, der hedder "opslag_i_fusionssag_projekt_falk", har allerede afsløret noget.
- Fejlbeskeder. En resolver, der svarer med et databasenavn, en tabel eller en stak-sporing, lækker arkitekturen.
- Logs. MCP-server, API-gateway og overvågning gemmer ofte hele svaret. Så er lækagen bare flyttet et andet sted hen.
Derfor bør laget have to kontroller, ikke én. Den første spørger, om brugeren må se feltet. Den anden spørger, om feltet må sendes til netop den model. Svarene er ikke altid ens. En sygeplejerske må godt se en patients diagnose, men det betyder ikke, at diagnosen må gå til en amerikansk sky.
PII-maskering var bygget til en verden, hvor et menneske kopierede tekst ind i en chat. Agenter henter selv dataene, kombinerer dem på tværs af systemer og handler på dem. Det kræver adgangsstyring, der er lige så præcis som den, man ville give en ny medarbejder, og som håndhæves af et system, ikke af en prompt.
Kilder: The New Stack · Apollo GraphQL · OWASP Top 10 for LLM · EDPB om pseudonymisering · Lermen m.fl., arXiv · Københavns Universitet · Harvard Law Review om Heppner · Datatilsynet
