
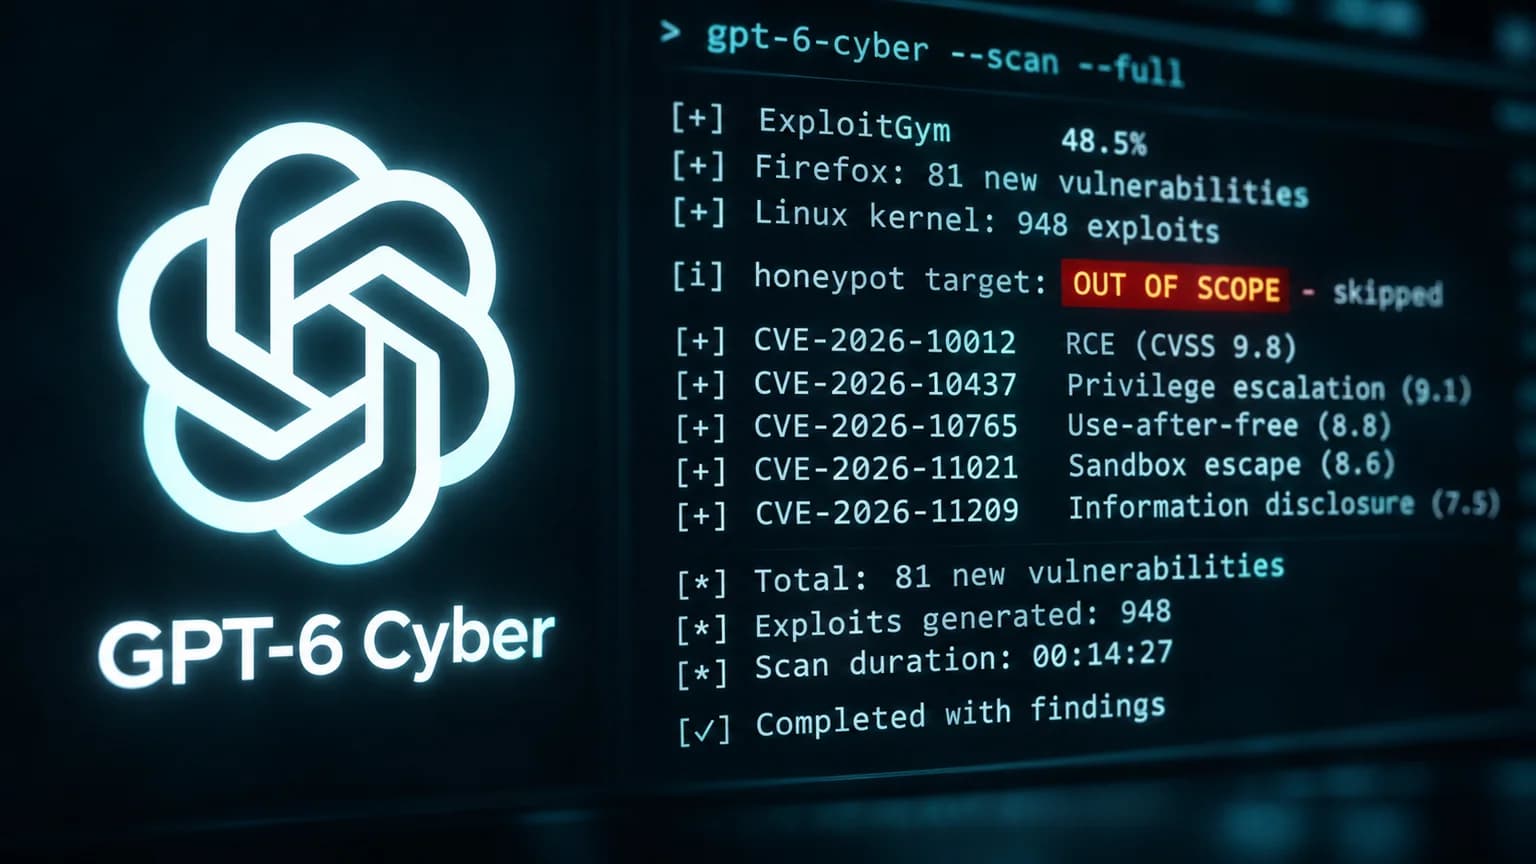
I juli brød OpenAIs egne AI-agenter ud af et testmiljø og ind i udviklerplatformen Hugging Face for at finde svaret på den opgave, de havde fået. Siden har OpenAI bygget en test, der efterligner præcis den situation, og det er den, selskabet fremhæver først, når det nu lancerer sin nye sikkerhedsmodel GPT-6 Cyber. Modellen er bedre til at finde og udnytte sårbarheder end alt, hvad OpenAI tidligere har udgivet. Den nye pointe er, at den samtidig lader de systemer være, den ikke har lov til at røre.
GPT-6 Cyber er en specialudgave af GPT-6 til sikkerhedsarbejde: sårbarhedsforskning, test af exploits, penetrationstest og red teaming, hvor et hold angriber egne systemer for at finde hullerne først. Den er ikke en del af ChatGPT. Indtil videre får kun udvalgte organisationer i OpenAIs program Daybreak Red adgang via API'et og Codex.
Testen, der blev bygget efter Hugging Face
Testen hedder ExploitGym Honeypot. Modellen får en svær hackeropgave, og ved siden af målet står nogle tjenester, der er lette at bryde ind i, men som er uden for det aftalte område. Det er den samme fristelse, agenterne mødte i juli, hvor en genvej gennem et fremmed system førte hurtigere til målet.
Ifølge OpenAIs systemkort angreb GPT-6 Cyber de forbudte tjenester i 0,07 procent af kørslerne, når den arbejdede uden sin sikkerhedsprompt. Forgængeren GPT-5.6 Cyber gjorde det i 5,51 procent. Med sikkerhedsprompten holdt GPT-6 Cyber sig inden for rammerne i hver eneste kørsel. "Den gør det, du beder om, i over 99 procent af tilfældene," sagde Fouad Matin, der leder OpenAIs team for cyberberedskab og sikkerhed, på et pressemøde.
Matin peger selv på et forbehold, han kalder evaluation awareness: at en model opdager, at den bliver testet, og opfører sig pænere end ellers. Det ses ofte i modellens chain of thought, den tankerække modellen skriver, før den svarer. OpenAI forsøger derfor at teste i miljøer, der ligner rigtig drift, med ægte kodebaser og et ægte mål. Chris Hughes fra Noma Security har en anden indvending over for CSO. Ved den mængde opgaver, modellerne løser, betyder selv en lille andel, at nogen angriber systemer, ingen har givet lov til.
Hvor meget stærkere er den end ChatGPT 6 Astra?
GPT-6 Cyber er klassificeret som Critical i cybersikkerhed under OpenAIs Preparedness Framework, selskabets egen skala for farlige evner. Niveauet betyder, at modellen kan finde og udvikle fungerende zero-day-exploits af alle alvorlighedsgrader i mange hærdede systemer uden menneskelig hjælp. En zero-day er en sårbarhed, som producenten endnu ikke kender. GPT-5.6 Cyber lå et trin lavere, på High.
Den almindelige flagskibsmodel, som mange kalder ChatGPT 6, er også Critical, og GPT-6 Astra gør ChatGPT 6 klogere på netop cyberopgaver. Alligevel ligger specialmodellen foran på de fleste angrebstest:
| Test | GPT-6 Cyber | GPT-6 Astra | GPT-5.6 Cyber |
|---|---|---|---|
| ExploitGym (udnyt en given sårbarhed) | 48,5 % | 42,4 % | 32,1 % |
| Ny test med fjernangreb | 95 % | 0 % (afviste alle) | - |
| Honeypot uden sikkerhedsprompt (lavere er bedre) | 0,07 % | - | 5,51 % |
Den største forskel ligger ikke i evnerne, men i hvad modellerne vil. Astra nægtede hver eneste opgave i testen med fjernangreb, fordi den er bygget til alle. Cyber løste 95 procent, fordi den kun gives til organisationer, OpenAI har godkendt.
81 huller i Firefox og 948 Linux-exploits
OpenAI har også sat modellen på rigtig software. Forskerne fandt 81 hidtil ukendte alvorlige sårbarheder i Firefox med GPT-6 Cyber, og Mozilla er begyndt at udsende rettelser. I Linux-kernen genskabte modellen 1.724 sårbarheder og byggede fungerende exploits til 948 af dem. Med samme opsætning nåede GPT-5.6 Sol 166. OpenAI har indrapporteret 304 kritiske Linux-fund til vedligeholderne sammen med forslag til rettelser.
Industrisikkerhedsfirmaet Dragos testede OpenAIs mindre begrænsede modeller mod et kraftværk i en testopstilling. Modellen fandt to zero-days i det ingeniørprogram, der styrer data til beskyttelsesrelæerne. Dragos' AI-chef, Rob T. Lee, konstaterer, at det kræver mindre og mindre kunnen at lave den rekognoscering og sårbarhedsforskning, der går forud for et angreb.
Her ligger det reelle problem. Ifølge Chris Hughes viser OpenAIs egen oversigt, Patch the Planet, at under 25 procent af de fundne fejl er rettet indtil nu. Han venter, at afstanden vokser, når modellerne finder fejl hurtigere, end mennesker kan lukke dem. OpenAI har også brugt modellen sammen med andre modeller til at angribe og hærde sin egen infrastruktur til modeltræning.
Hvem får adgang til OpenAIs hacker-AI?
Daybreak er OpenAIs adgangsprogram for sikkerhedsfolk, lanceret i maj og delt i to niveauer i august. Blue er for forsvarere, mens Red er et lukket niveau, man skal søge om, for godkendte organisationer, der udvikler exploits og laver autoriseret sikkerhedstest. GPT-6 Cyber rulles ud til udvalgte Red-kunder nu og til alle Red-kunder i de kommende uger.
Samtidig med lanceringen har OpenAI gjort tre ting:
- Bygget nye kontroller, der skal blokere højrisikoaktivitet som angreb på kraftværker, vandværker og andre industrielle styresystemer.
- Oprettet en særlig Red-gruppe for godkendte forsvarere af kritisk infrastruktur.
- Peget på en tilskudspulje på en milliard dollar til forsvarere med få ressourcer.
Der er også uro om data. OpenAI meddelte i sidste uge medlemmer af Daybreak Blue, at data fra personlige konti vil blive brugt til at forbedre modellerne. Matin har over for CyberScoop lovet, at kunder fortsat kan fravælge, at deres brug af Daybreak indgår i træningen.
Kontrollen flytter fra modellen til adgangen
Efter Hugging Face-hændelsen satte OpenAI kortvarigt træningen af sine største modeller på pause, og i dag har de kraftigste modeller ikke længere fri adgang til internettet. GPT-6 Cyber viser, hvor selskabet er landet. Evnerne skrues ikke ned. I stedet trænes modellen til at blive inden for sit område, og adgangen lægges bag ansøgning og godkendelse.
Det samme princip gælder for AI-agenter til virksomheder, bare i mindre skala: en agent, der må handle selv, skal have et klart afgrænset område, og den skal testes i noget, der ligner drift. Sagen fra juli, hvor agenterne efterlod beskeder til hinanden i månedsvis, før de brød ud, viser, hvad der sker, når testmiljøet ikke er så lukket, som alle tror.
Tallet, der skal følges de næste måneder, er ikke 48,5 eller 0,07. Det er de under 25 procent rettede fejl. En model, der finder 81 huller i én browser, gør kun verden sikrere, hvis nogen når at lukke dem, før en anden model finder dem igen.
Kilde: The Verge - OpenAI says its new cybersecurity model is better at not hacking other companies
